

Etapa Table Append
Descrição
Seção intitulada “Descrição”Adiciona linhas de uma tabela de origem ao final de uma tabela de destino existente. As linhas existentes no destino são preservadas; apenas as linhas novas são inseridas. Use-a quando os dados chegam de forma incremental (por exemplo, extrações diárias, arquivos de carga mensais) e você quer que o destino cresça ao longo do tempo, em vez de ser substituído.
Se precisar remover duplicatas ao anexar, use em seguida uma etapa Table Union Distinct ou use Table Upsert se algumas linhas atualizarem registros existentes por chave.
Parâmetros de carga
Seção intitulada “Parâmetros de carga”Origem e destino
Seção intitulada “Origem e destino”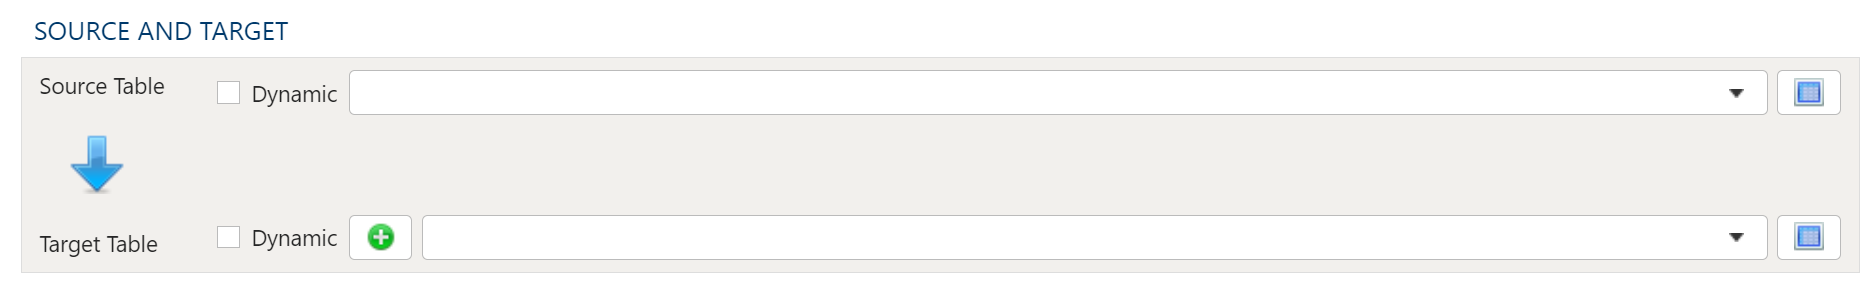
Para definir as tabelas de origem e de destino, primeiro selecione a tabela de dados da qual extrair na lista suspensa Tabela de origem. Em seguida, selecione uma tabela existente como tabela de destino na lista suspensa Tabela de destino.
Seleção de dados da tabela
Seção intitulada “Seleção de dados da tabela”Ao configurar o Data Mapper, as colunas da tabela de origem devem ser mapeadas para uma coluna da tabela de destino.
Configuração do Data Mapper
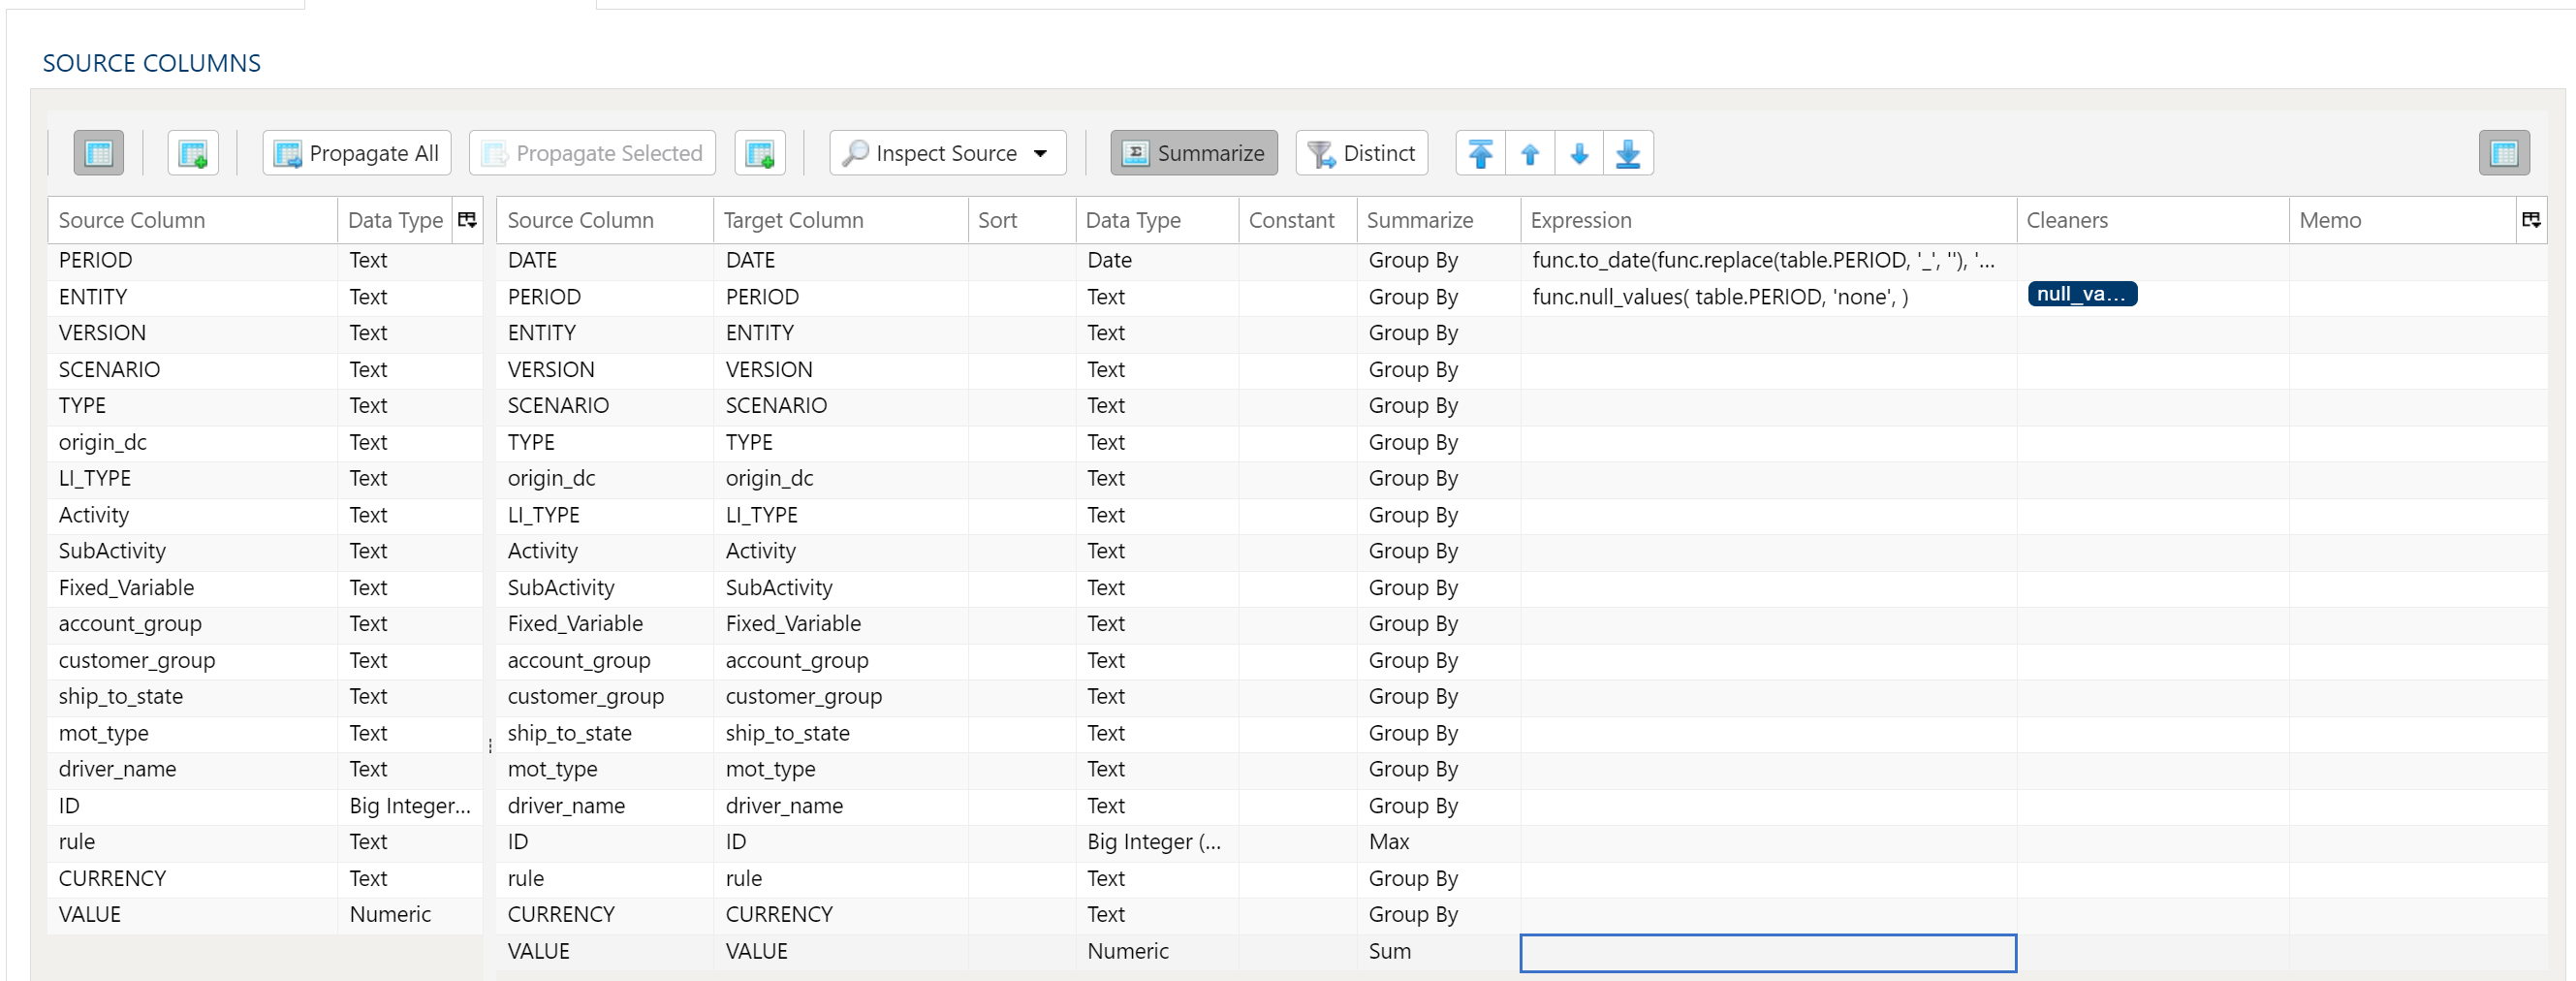
O Data Mapper é usado para mapear as colunas dos dados de origem para a tabela de dados de destino.
Inspeção e Preenchimento do Mapeador
O botão de menu Inspecionar origem oferece formas adicionais de mapear colunas da origem para o destino:
- Preencher ambas as tabelas de mapeamento: propaga todos os valores da tabela de dados de origem para a tabela de dados de destino. Este é o comportamento padrão.
- Preencher somente a tabela de mapeamento de origem: mapeia apenas todos os valores da tabela de dados de origem. Isso é útil ao modificar um fluxo de trabalho existente quando a estrutura de colunas da origem mudou.
- Preencher somente a tabela de mapeamento de destino: propaga todos os valores apenas para a tabela de dados de destino.
Se as opções de coluna de origem e de destino não forem suficientes, é possível adicionar outras colunas à tabela de dados de destino de várias maneiras:
- Propagar tudo insere todas as colunas de origem na tabela de dados de destino, quer elas já existam ou não.
- Propagar selecionadas insere apenas as colunas de origem selecionadas.
- Clique com o botão direito no lado do destino e selecione Inserir linha para inserir uma linha imediatamente acima da linha selecionada.
- Clique com o botão direito no lado do destino e selecione Anexar linha para inserir uma linha no final (extrema direita) da tabela de dados de destino.
Exclusão de Colunas
Para excluir colunas da tabela de dados de destino, selecione as colunas desejadas, clique com o botão direito e selecione Excluir.
Colunas de Origem que Não Estão Mais Listadas
Uma linha de destino pode indicar uma Coluna de origem que a tabela de dados de origem não lista mais, por exemplo depois que a origem foi inspecionada novamente. A etapa nunca remove essa linha por você. Em vez disso, o nome da coluna aparece em vermelho, após um sinal de aviso ⚠, e ao passar o mouse sobre ele é exibida a informação de que a coluna não está nas colunas de origem. Em uma etapa com várias tabelas, como uma união, cada tabela é verificada em relação às suas próprias colunas de origem.
Uma linha com resumo Constante, Expressão ou Contagem (incluindo nulos) nunca é sinalizada, porque a etapa não lê a coluna de origem dela. Nada é sinalizado enquanto a tabela de dados de origem não listar nenhuma coluna, por exemplo antes de a origem ser inspecionada pela primeira vez.
Ao salvar uma etapa que ainda tem linhas sinalizadas, uma caixa de diálogo Colunas obsoletas encontradas as lista sob a guia ou a tabela em que estão e oferece três opções:
- Remover todas e salvar — remove as linhas sinalizadas e, em seguida, salva.
- Salvar mesmo assim — salva a etapa como está.
- Cancelar — volta para a etapa sem salvar.
Para manter uma linha e eliminar o aviso dela, adicione a coluna de volta à tabela de dados de origem ou escolha uma coluna que a tabela de dados de origem liste.
Colunas ausentes na tabela de origem
Ao salvar, a própria tabela de dados de origem é verificada no estado atual. Uma coluna que a etapa lista nas colunas de origem, mas que a tabela não tem, por exemplo uma que uma etapa anterior renomeou ou removeu, significa que as colunas da etapa estão desatualizadas, e uma etapa que lê essa coluna falha ao ser executada. Nesse caso, ao salvar, abre-se uma caixa de diálogo Colunas de origem ausentes que informa cada tabela e as colunas que faltam nela, com duas opções:
- Salvar mesmo assim — salva a etapa como está.
- Cancelar — volta para a etapa sem salvar.
Nada é removido automaticamente, porque o problema pode estar na tabela, e ela pode mudar de novo antes da execução da etapa. Quando há também linhas sinalizadas como não listadas, ambas aparecem juntas na caixa de diálogo Colunas obsoletas encontradas, e Remover todas e salvar remove apenas as linhas sinalizadas. Enquanto a lista de colunas de origem estiver vazia, são verificadas as colunas que a etapa mapeia, exceto as linhas com resumo Constante, Expressão ou Contagem (incluindo nulos), que não leem nenhuma coluna.
Uma origem nomeada com uma variável, como {year}/Sales, é verificada com o valor da variável no momento em que você salva, e a caixa de diálogo informa a tabela verificada, como 2026/Sales (from {year}/Sales). Uma variável definida por um loop contém o valor da última iteração, portanto um loop sobre tabelas com estruturas diferentes pode alertar sobre uma tabela que a próxima execução não vai ler. Não são verificadas uma tabela que ainda não existe, por exemplo uma criada por uma etapa anterior do fluxo de trabalho, uma origem cuja variável não tem valor, uma tabela que a etapa localiza por pesquisa durante a execução ou uma tabela que não pode ser lida no momento.
Colunas de destino que faltam na tabela de destino
Esta etapa grava na tabela de destino no estado em que ela está e nunca adiciona uma coluna a ela, então uma execução falha em uma Coluna de destino que a tabela não tem. Quando a etapa é aberta, e novamente sempre que você escolhe outra tabela de destino, o formulário lê as colunas da tabela de destino, preenchendo qualquer variável no nome dela com as variáveis do fluxo de trabalho. Cada Coluna de destino que a tabela não tem aparece em vermelho, após um sinal de aviso ⚠, e ao passar o mouse sobre ela é exibida a mensagem A coluna “discount” não está na tabela de destino. Os nomes são comparados sem diferenciar maiúsculas e minúsculas, então Discount corresponde a discount. Essa marca se soma à que aparece em uma Coluna de origem que as colunas de origem não listam mais, com a mensagem A coluna “discount” não está nas colunas de origem.
Nada é marcado enquanto a tabela de destino ainda não existe, porque a execução a cria a partir do mapeamento, nem enquanto as colunas dela não podem ser lidas.
Ao salvar uma etapa com uma linha marcada dessa forma, a caixa de diálogo Colunas obsoletas encontradas lista as linhas marcadas sob Colunas, abaixo de Estas linhas indicam uma coluna que a etapa não pode usar:, e termina com A etapa não pode ser salva até que as colunas que faltam na tabela de destino sejam adicionadas a ela ou que suas linhas sejam removidas. Ela oferece duas opções:
- Remover todas e salvar — remove todas as linhas marcadas, de modo que essas colunas deixam de ser carregadas, e em seguida salva.
- Cancelar — volta para a etapa sem salvar.
Não há Salvar mesmo assim, porque o servidor se recusa a salvar um mapeamento que indique uma coluna que a tabela de destino existente não tem. Para manter uma linha, adicione a coluna dela à tabela de destino e salve a etapa novamente. A exceção é uma tabela de destino nomeada com uma variável, como {year}/Sales: o servidor deixa essa verificação para a execução, então a caixa de diálogo ainda oferece Salvar mesmo assim.
Quando as linhas estão marcadas apenas pela Coluna de origem, a caixa de diálogo oferece Remover todas e salvar, Salvar mesmo assim e Cancelar, conforme descrito acima.
Quando a etapa é executada
As etapas Table Extract, Table Lookup, Table Inner Join, Table Cross Join, Table Outer Join, Table Anti Join, Junção de várias tabelas, Table Union Distinct, Table Union All, Table Pivot, Table Melt, Table In-Place Delete, Table Upsert e Table Append verificam suas tabelas de origem quando são executadas, antes de gravar qualquer coisa. A verificação compara a consulta que a etapa montou com cada tabela de origem como ela está naquele momento:
- Uma coluna que a etapa lê e que a tabela não tem, uma chave de junção que a tabela não tem ou que não está nas colunas de origem da etapa, ou uma tabela de origem que a etapa lê e que não foi construída interrompe a etapa. Um único erro nomeia todos os problemas, cada um com a sua própria correção. Uma tabela de destino que já existia permanece como estava, e uma que a etapa precisou criar fica vazia.
- Uma coluna que a etapa lista, mas não lê, e que a tabela não tem mais, gera um aviso. A etapa é executada sem ela.
- Table Union Distinct e Table Union All são a exceção para uma tabela de origem que não foi construída: elas a deixam de fora, sem aviso, e combinam as demais, como antes. Se nenhuma das tabelas de origem tiver sido construída, elas terminam com um aviso em vez de falhar.
Uma etapa cujo destino é uma visão apenas cria a visão, portanto as colunas e as chaves de junção que ela lista são verificadas em relação às suas tabelas somente quando o warehouse se recusaria a criar essa visão de qualquer forma. Nos demais casos, apenas uma tabela de origem que não foi construída ou uma chave de junção que a etapa não lista a interrompe, e nenhum aviso é adicionado.
Sempre que possível, o erro nomeia a etapa que constrói uma tabela e, quando a tabela tem uma coluna cujo nome é parecido com o de uma coluna ausente, por exemplo uma que difere apenas na caixa das letras, ele nomeia essa coluna também.
Tipo de Dados da Coluna
Toda coluna de destino tem um Tipo. Uma coluna propagada da origem mantém o tipo da coluna de origem; uma linha que você adiciona manualmente começa como Texto, e você define o Tipo para indicar o que ela deve realmente ser — uma coluna que você pretende somar ou ordenar precisa do tipo numérico ou de data, porque texto é ordenado e somado como texto.
Uma etapa salva com uma coluna sem nenhum tipo ainda é executada. O tipo é determinado quando a etapa é iniciada, a partir da coluna de origem que essa coluna lê. Onde não há de onde lê-lo, ele é tratado como texto: as colunas de uma etapa Extrair SQL vêm da consulta que você escreveu, e não de uma origem mapeada, e onde várias origens têm o mesmo nome de coluna com tipos divergentes, usa-se texto em vez de adivinhar um deles — um palpite errado gera uma conversão que o data warehouse pode rejeitar, e qualquer coisa pode ser convertida em texto.
Definir o Tipo você mesmo continua sendo a forma de dizer o que uma coluna deve ser. Deixá-lo sem definição significa aceitar o tipo que a coluna de origem tiver.
Alteração da Ordem das Colunas
Para reorganizar as colunas na tabela de dados de destino, selecione as colunas desejadas. Você pode usar:
- Setas de movimentação em massa: selecione a opção de movimentação desejada nas setas no canto superior direito
- Menu de contexto: clique com o botão direito e selecione Mover para o início, Mover para cima, Mover para baixo ou Mover para o final.
Reduzir o Resultado a Registros Distintos
Para retornar apenas opções distintas, selecione a opção de menu Distintos. Isso exibe um conjunto de caixas de seleção para cada coluna da origem. Basta marcar a caixa ao lado da coluna correspondente para retornar apenas resultados distintos.
Dependendo da situação, talvez seja melhor considerar o uso de resumo.
O processo de distinção mantém o primeiro registro exclusivo encontrado e descarta os demais. Talvez você queira aplicar uma ordenação aos dados se a consistência entre execuções for importante.
Agregação e Agrupamento
Para agregar resultados, selecione a opção de menu Resumir. Isso exibe um conjunto de caixas de seleção para cada coluna da tabela de dados de destino. Escolha um método de resumo adequado para cada coluna.
Quando Inspecionar origem preenche as colunas, uma coluna numérica começa como Agrupar por em vez de Soma se o nome dela se parecer com um identificador, como id, customer_id, Order No ou CustomerKey, se a tabela dela a definir como chave ou se a junção a usar como chave.
- Agrupar por
- Soma
- Mínimo
- Máximo
- Primeiro
- Último
- Contagem
- Contagem (incluindo nulos)
- Média
- Desvio padrão
- Desvio padrão amostral
- Desvio padrão populacional
- Variância
- Variância amostral
- Variância populacional
- Avançado sem Agrupar por
Para uso avançado do Data Mapper, como expressões, limpeza e constantes, consulte Uso avançado do Data Mapper
Filtros de dados
Seção intitulada “Filtros de dados”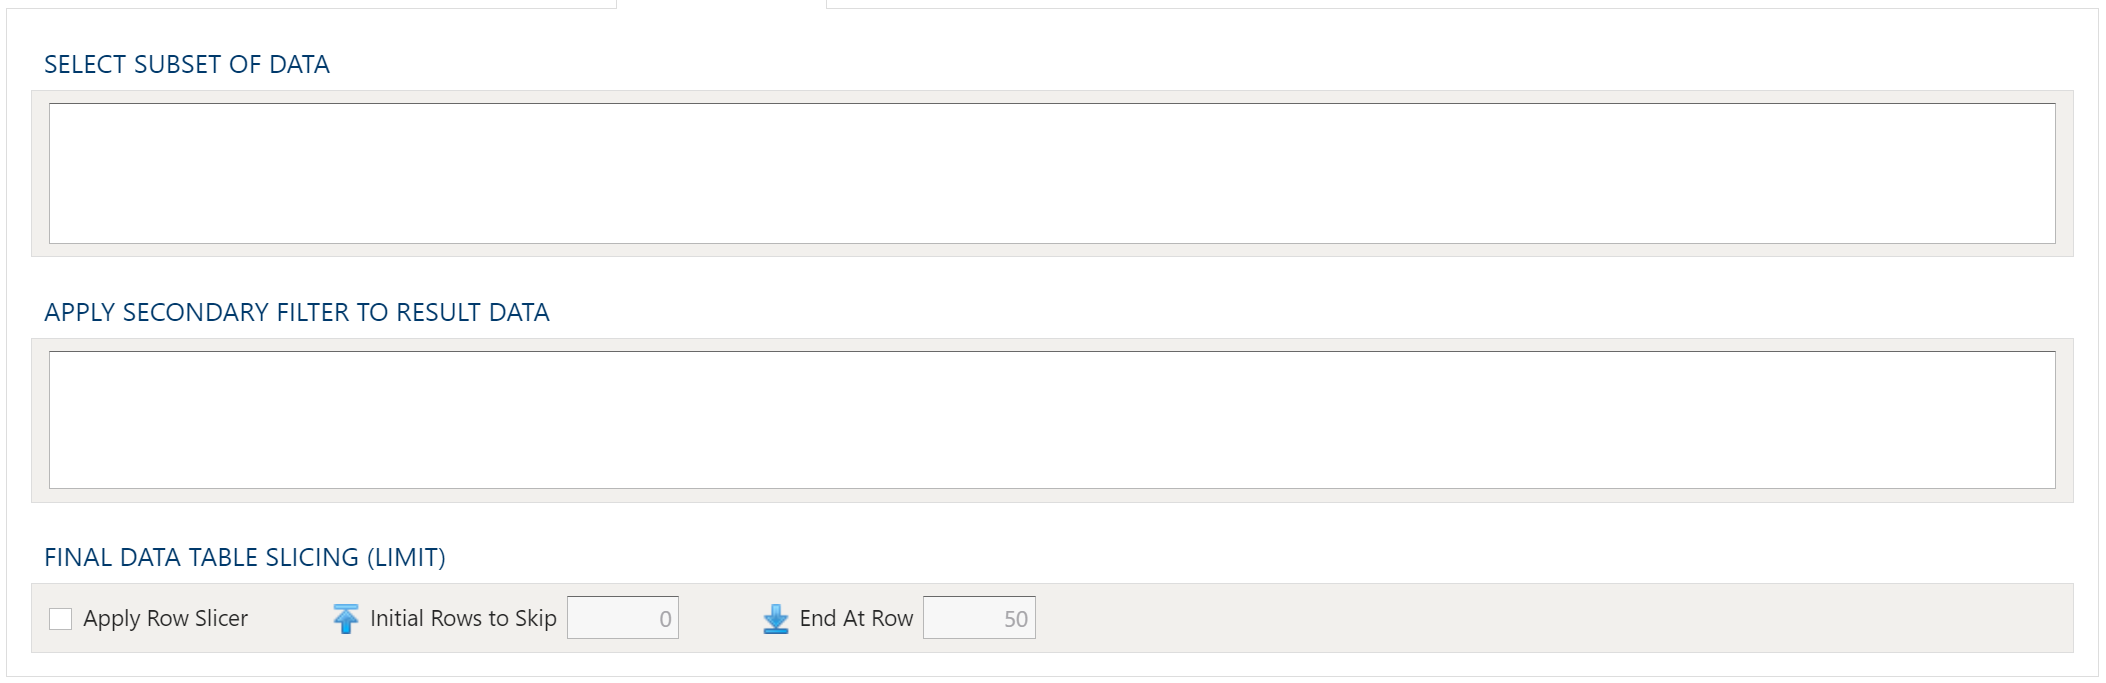
Para oferecer o máximo de flexibilidade, há filtros de dados tanto nos dados de origem quanto nos dados de destino. Em conjuntos de dados maiores, filtrar linhas na origem pode ser especialmente vantajoso, pois as demais operações são executadas sobre um conjunto de dados menor.
Selecionar subconjunto de dados
Este tipo de filtro permite filtrar os dados de origem de entrada com base nas condições especificadas.
Aplicar filtro secundário aos dados de resultado
Este tipo de filtro permite aplicar um filtro aos dados de resultado já transformados, com base nas condições especificadas. Aplicar um filtro ao resultado transformado permite fazer exclusões com base em resultados de cálculos complexos, sumarizações ou funções de janela.
Divisão final da tabela de dados (limite)
O recurso de divisão de linhas permite limitar as linhas do conjunto de resultados com base em um intervalo e um ponto de partida.
Sintaxe de filtro
A sintaxe de filtro usa o Python SQLAlchemy, a mesma sintaxe das outras expressões.
Veja exemplos e funções de expressão na área Expressões.
O que é verificado ao salvar
Seção intitulada “O que é verificado ao salvar”- O mapeamento se ajusta a uma tabela de destino existente. Quando a tabela de destino já existe, a etapa não pode mapear uma coluna que a tabela não tem nem dar a uma coluna um tipo diferente do da tabela. Numérico e moeda contam como o mesmo tipo. Uma coluna da tabela que o mapeamento deixa de fora é permitida e fica vazia nas linhas anexadas. A recusa cita cada diferença, por exemplo, The target columns must match the existing target table ‘sales’. Types differ: amount (table: numeric, step: text). Uma tabela de destino que ainda não existe, ou nomeada com uma variável, é verificada quando a etapa é executada. A guia Colunas marca uma coluna que a tabela não tem antes de você salvar e, a menos que a tabela seja nomeada com uma variável, ao salvar é oferecida apenas a remoção da linha dela. Consulte Colunas de destino que faltam na tabela de destino.
- Um mapeamento vazio é preenchido para você. Ao salvar com uma tabela de origem escolhida, mas sem colunas de origem ou de destino, o lado vazio é preenchido a partir da origem, como faria Preencher ambas as tabelas de mapeamento.