

Etapa Table Anti Join
Descrição
Seção intitulada “Descrição”A Table Anti Join fornece o conjunto de itens sem correspondência entre duas tabelas. Ela retorna a lista de itens da primeira tabela que não têm correspondência na segunda tabela. Isso pode ser muito útil para determinar quais registros estão presentes em uma tabela, mas não em outra.
Essa operação poderia ser feita usando junções externas e filtrando valores nulos na junção; porém, a transformação de anti-junção faz isso de forma mais eficiente e mais clara.
Seleção de dados da tabela
Seção intitulada “Seleção de dados da tabela”Origem da tabela
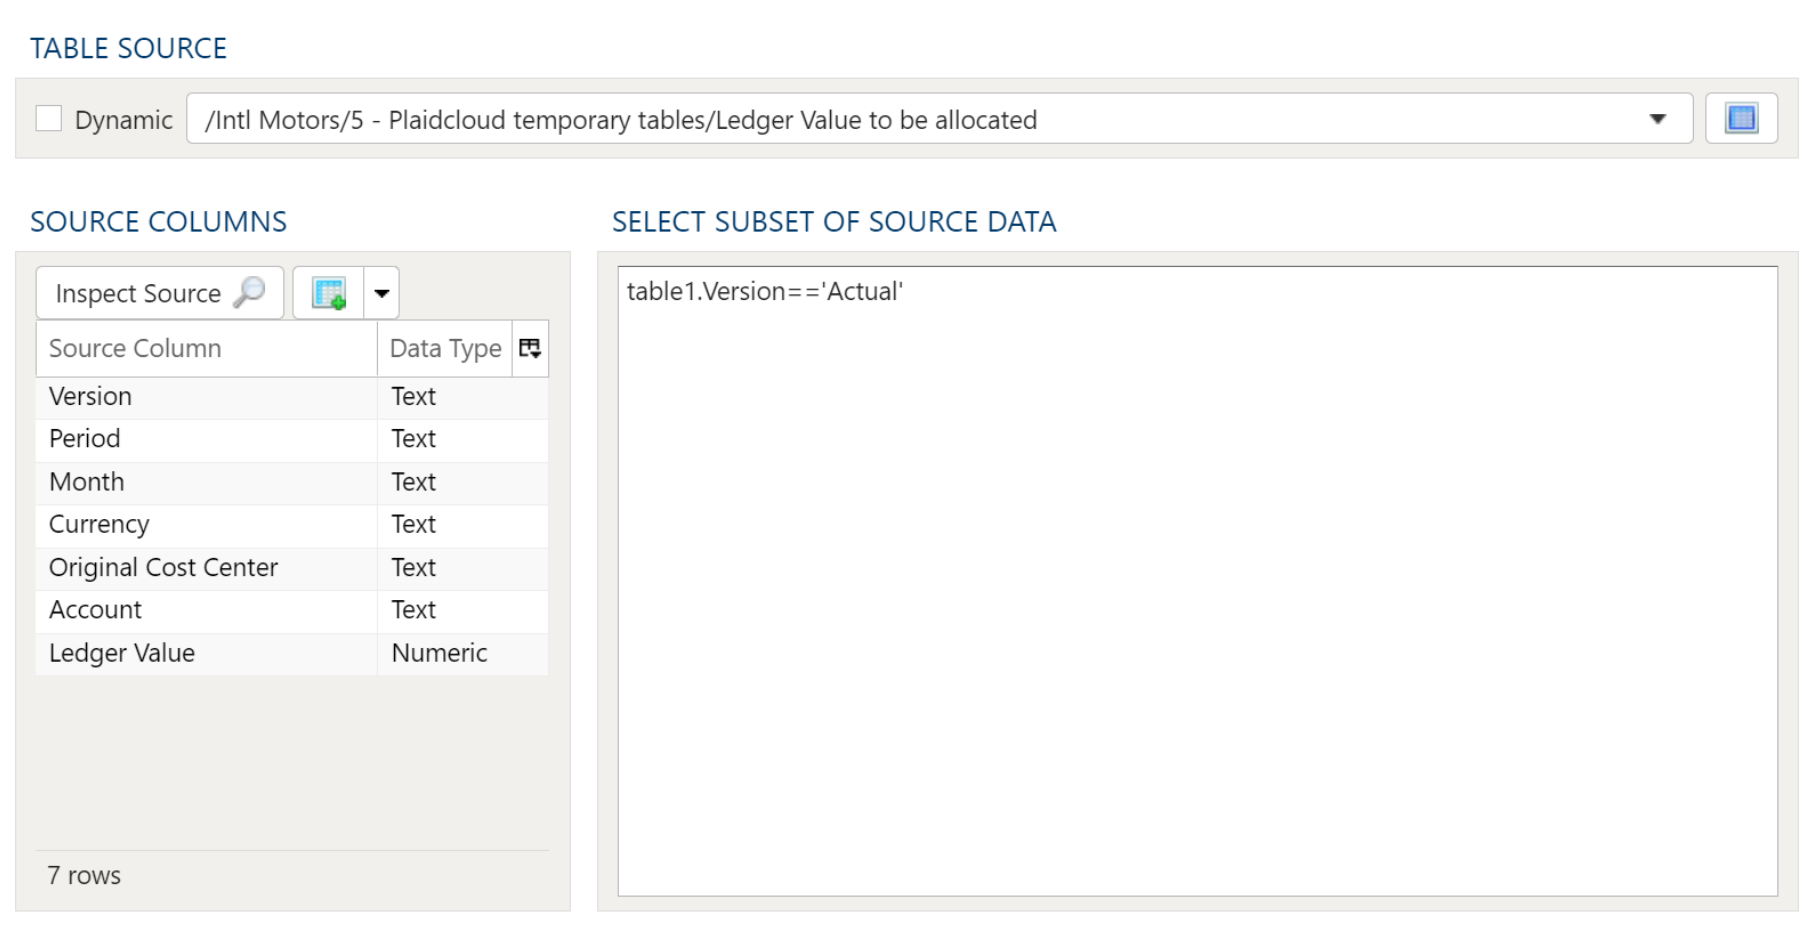
Especifique a tabela de dados de origem selecionando-a no menu suspenso.
Colunas de origem
Especifique aqui as colunas a serem incluídas. Ao selecionar os botões Inspecionar origem e Populate Source Mapping Table, essas colunas ficam disponíveis para a operação de junção.
Selecionar subconjunto dos dados de origem
Qualquer expressão Python válida é aceita para obter um subconjunto dos dados. Consulte Expressões para mais detalhes e exemplos.
Colunas nomeadas durante a execução
Seção intitulada “Colunas nomeadas durante a execução”Selecione Levar também colunas nomeadas durante a execução para passar adiante, sem alteração, toda coluna de origem que a etapa não lista, como a tabela as tem quando a etapa é executada. Use essa opção quando uma etapa anterior cria colunas cujos nomes dependem dos dados, como um pivô, de modo que você não consegue listá-las ao montar a etapa. Deixe-a desativada para gravar apenas as colunas que você listar.
Saída da tabela
Seção intitulada “Saída da tabela”Tabela de destino

Para definir a tabela de destino, selecione uma tabela existente na lista suspensa Tabela de destino ou clique no sinal verde “+” para criar uma nova tabela como destino.
Criação de tabela
Ao criar uma nova tabela, você pode criá-la como Visão ou como Tabela.
Visões:
As visões são úteis porque o tempo necessário para executar uma etapa é bem menor do que quando se usa uma tabela. A desvantagem das visões é que elas não são úteis para explorar dados no modo Detalhes da tabela.
Tabelas:
Ao usar uma tabela como destino, a etapa leva mais tempo para ser executada, mas a exploração de dados no modo Detalhes é muito mais rápida do que com uma visão.
Mapa de junção
Seção intitulada “Mapa de junção”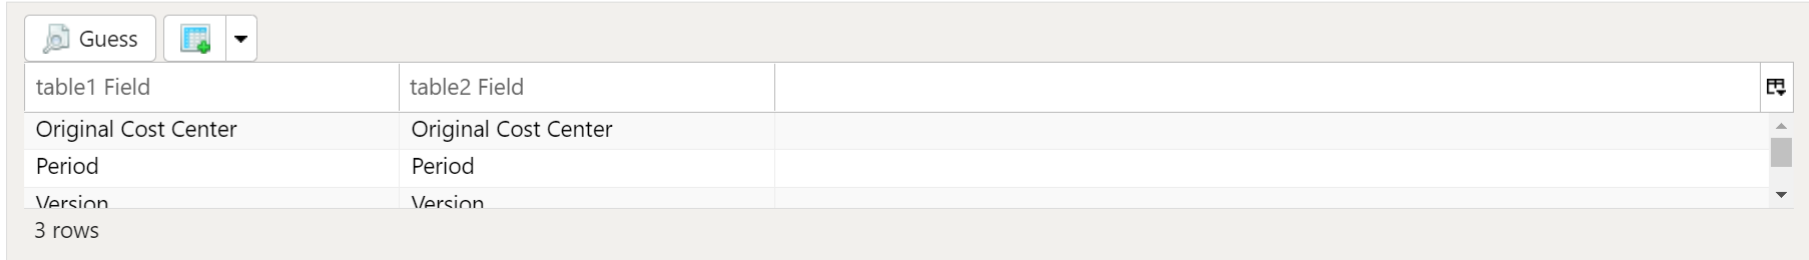
Especifique as condições de junção. Detectar preenche o Join Map com a primeira destas opções que as colunas das duas tabelas permitirem:
- as chaves de outra etapa de junção deste projeto que une as mesmas duas tabelas
- as chaves de uma métrica aprovada que as une
- as colunas-chave definidas em uma das tabelas, correspondidas por nome na outra
- as colunas com o mesmo nome em Table 1 e Table 2
- colunas cujos nomes diferem apenas em maiúsculas ou sublinhados, ou uma coluna
idcorrespondida a uma coluna com o nome da própria tabela, comocustomer_idpara uma tabela chamada Customers
Uma linha abaixo do mapa informa qual delas foi usada, até você alterar o mapa. Detectar lê as colunas das tabelas, não as linhas, portanto verifique as chaves antes de salvar. Inspecionar origem preenche um Join Map vazio da mesma forma.
Para adicionar colunas manualmente, clique com o botão direito em qualquer parte da seção e selecione Inserir linha ou Anexar linha, para adicionar uma linha antes da linha selecionada ou no final, respectivamente. Depois, digite os nomes das colunas a serem correspondidas de Table 1 para Table 2. Para remover um campo do Join Map, basta clicar com o botão direito e selecionar Excluir.
Colunas de saída de destino
Seção intitulada “Colunas de saída de destino”Configuração do Data Mapper
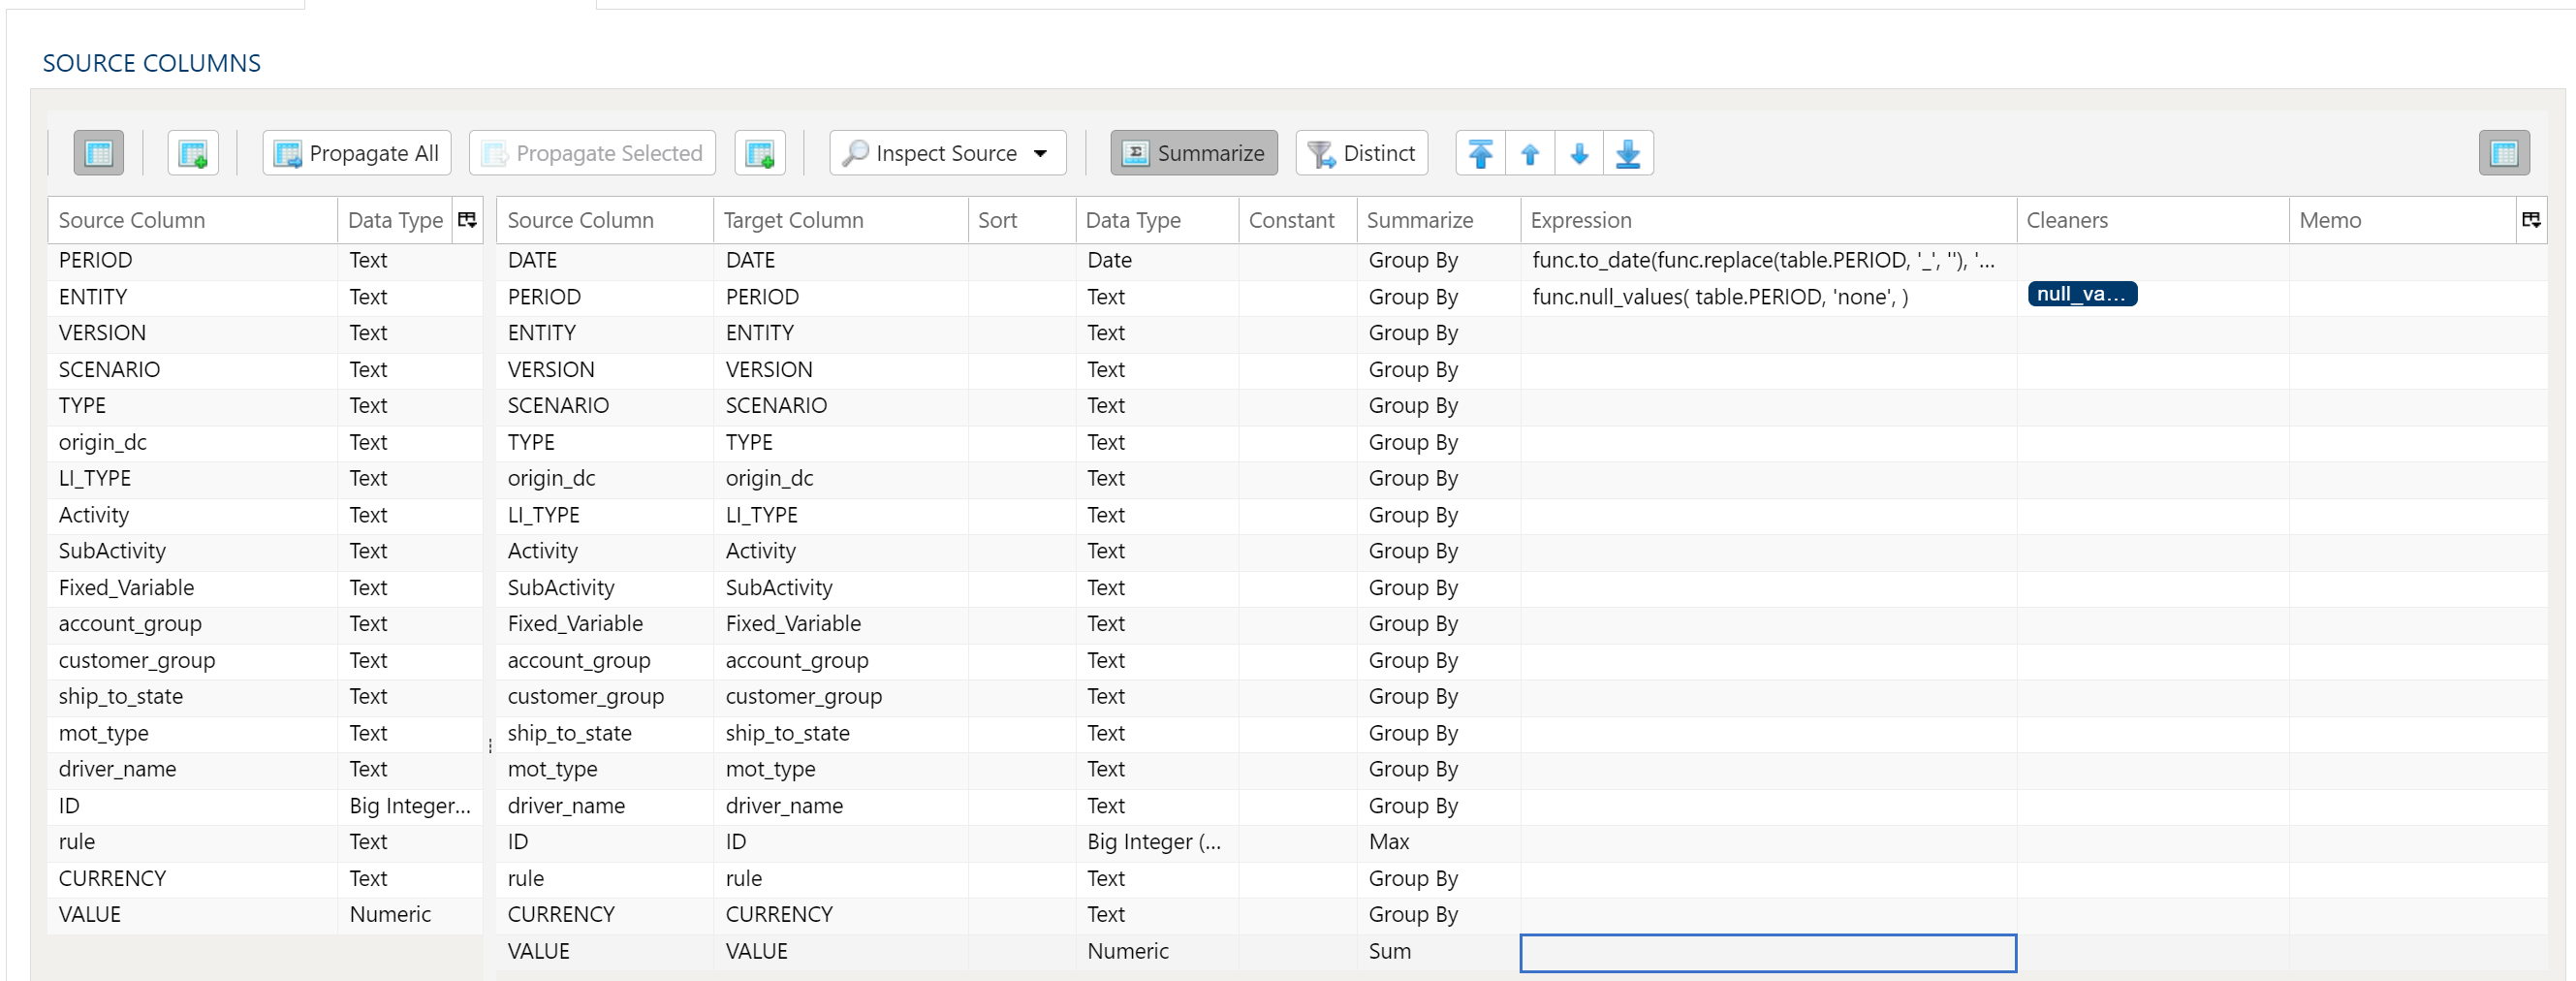
O Data Mapper é usado para mapear as colunas dos dados de origem para a tabela de dados de destino.
Inspeção e Preenchimento do Mapeador
O botão de menu Inspecionar origem oferece formas adicionais de mapear colunas da origem para o destino:
- Preencher ambas as tabelas de mapeamento: propaga todos os valores da tabela de dados de origem para a tabela de dados de destino. Este é o comportamento padrão.
- Preencher somente a tabela de mapeamento de origem: mapeia apenas todos os valores da tabela de dados de origem. Isso é útil ao modificar um fluxo de trabalho existente quando a estrutura de colunas da origem mudou.
- Preencher somente a tabela de mapeamento de destino: propaga todos os valores apenas para a tabela de dados de destino.
Se as opções de coluna de origem e de destino não forem suficientes, é possível adicionar outras colunas à tabela de dados de destino de várias maneiras:
- Propagar tudo insere todas as colunas de origem na tabela de dados de destino, quer elas já existam ou não.
- Propagar selecionadas insere apenas as colunas de origem selecionadas.
- Clique com o botão direito no lado do destino e selecione Inserir linha para inserir uma linha imediatamente acima da linha selecionada.
- Clique com o botão direito no lado do destino e selecione Anexar linha para inserir uma linha no final (extrema direita) da tabela de dados de destino.
Exclusão de Colunas
Para excluir colunas da tabela de dados de destino, selecione as colunas desejadas, clique com o botão direito e selecione Excluir.
Colunas de Origem que Não Estão Mais Listadas
Uma linha de destino pode indicar uma Coluna de origem que a tabela de dados de origem não lista mais, por exemplo depois que a origem foi inspecionada novamente. A etapa nunca remove essa linha por você. Em vez disso, o nome da coluna aparece em vermelho, após um sinal de aviso ⚠, e ao passar o mouse sobre ele é exibida a informação de que a coluna não está nas colunas de origem. Em uma etapa com várias tabelas, como uma união, cada tabela é verificada em relação às suas próprias colunas de origem.
Uma linha com resumo Constante, Expressão ou Contagem (incluindo nulos) nunca é sinalizada, porque a etapa não lê a coluna de origem dela. Nada é sinalizado enquanto a tabela de dados de origem não listar nenhuma coluna, por exemplo antes de a origem ser inspecionada pela primeira vez.
Ao salvar uma etapa que ainda tem linhas sinalizadas, uma caixa de diálogo Colunas obsoletas encontradas as lista sob a guia ou a tabela em que estão e oferece três opções:
- Remover todas e salvar — remove as linhas sinalizadas e, em seguida, salva.
- Salvar mesmo assim — salva a etapa como está.
- Cancelar — volta para a etapa sem salvar.
Para manter uma linha e eliminar o aviso dela, adicione a coluna de volta à tabela de dados de origem ou escolha uma coluna que a tabela de dados de origem liste.
Tipo de Dados da Coluna
Toda coluna de destino tem um Tipo. Uma coluna propagada da origem mantém o tipo da coluna de origem; uma linha que você adiciona manualmente começa como Texto, e você define o Tipo para indicar o que ela deve realmente ser — uma coluna que você pretende somar ou ordenar precisa do tipo numérico ou de data, porque texto é ordenado e somado como texto.
Uma etapa salva com uma coluna sem nenhum tipo ainda é executada. O tipo é determinado quando a etapa é iniciada, a partir da coluna de origem que essa coluna lê. Onde não há de onde lê-lo, ele é tratado como texto: as colunas de uma etapa Extrair SQL vêm da consulta que você escreveu, e não de uma origem mapeada, e onde várias origens têm o mesmo nome de coluna com tipos divergentes, usa-se texto em vez de adivinhar um deles — um palpite errado gera uma conversão que o data warehouse pode rejeitar, e qualquer coisa pode ser convertida em texto.
Definir o Tipo você mesmo continua sendo a forma de dizer o que uma coluna deve ser. Deixá-lo sem definição significa aceitar o tipo que a coluna de origem tiver.
Alteração da Ordem das Colunas
Para reorganizar as colunas na tabela de dados de destino, selecione as colunas desejadas. Você pode usar:
- Setas de movimentação em massa: selecione a opção de movimentação desejada nas setas no canto superior direito
- Menu de contexto: clique com o botão direito e selecione Mover para o início, Mover para cima, Mover para baixo ou Mover para o final.
Reduzir o Resultado a Registros Distintos
Para retornar apenas opções distintas, selecione a opção de menu Distintos. Isso exibe um conjunto de caixas de seleção para cada coluna da origem. Basta marcar a caixa ao lado da coluna correspondente para retornar apenas resultados distintos.
Dependendo da situação, talvez seja melhor considerar o uso de resumo.
O processo de distinção mantém o primeiro registro exclusivo encontrado e descarta os demais. Talvez você queira aplicar uma ordenação aos dados se a consistência entre execuções for importante.
Agregação e Agrupamento
Para agregar resultados, selecione a opção de menu Resumir. Isso exibe um conjunto de caixas de seleção para cada coluna da tabela de dados de destino. Escolha um método de resumo adequado para cada coluna.
Quando Inspecionar origem preenche as colunas, uma coluna numérica começa como Agrupar por em vez de Soma se o nome dela se parecer com um identificador, como id, customer_id, Order No ou CustomerKey, se a tabela dela a definir como chave ou se a junção a usar como chave.
- Agrupar por
- Soma
- Mínimo
- Máximo
- Primeiro
- Último
- Contagem
- Contagem (incluindo nulos)
- Média
- Desvio padrão
- Desvio padrão amostral
- Desvio padrão populacional
- Variância
- Variância amostral
- Variância populacional
- Avançado sem Agrupar por
Para uso avançado do Data Mapper, como expressões, limpeza e constantes, consulte Uso avançado do Data Mapper
Colunas obsoletas
Seção intitulada “Colunas obsoletas”Uma linha de Join Map ou de Colunas de saída de destino pode citar uma coluna que a guia Colunas de origem da etapa não lista mais, por exemplo depois de as colunas de uma origem serem inspecionadas novamente. A etapa nunca remove essa linha por você. Em vez disso, o nome da coluna aparece em vermelho depois de um sinal de alerta ⚠, e, ao passar o mouse sobre ele, você vê de qual origem a lista não tem a coluna.
Uma linha de Colunas de saída de destino com resumo Constante, Expressão ou Contagem (incluindo nulos) nunca é sinalizada, porque a etapa não lê a coluna de origem da linha. Nada é verificado em relação a uma origem cuja lista está vazia, por exemplo uma que nunca foi inspecionada.
Ao salvar uma etapa que ainda tem linhas sinalizadas, uma caixa de diálogo Colunas obsoletas encontradas lista essas linhas por tabela e oferece três opções:
- Remover todas e salvar — remove as linhas sinalizadas e depois salva.
- Salvar mesmo assim — salva a etapa como está.
- Cancelar — volta para a etapa sem salvar.
Para manter uma linha e limpar o alerta, adicione a coluna de volta à lista dessa origem na guia Colunas de origem ou escolha uma coluna que a lista contenha.
Ao salvar, cada tabela de origem também é verificada no estado atual. Uma coluna que a lista de uma origem contém, mas que a tabela não tem, abre uma caixa de diálogo Colunas de origem ausentes com o nome da tabela e da coluna, com as opções Salvar mesmo assim ou Cancelar. Quando há também linhas sinalizadas, ambas aparecem juntas na caixa de diálogo Colunas obsoletas encontradas. Consulte Colunas ausentes na tabela de origem.
Uma anti-junção gera colunas apenas da origem A, então uma linha de Colunas de saída de destino obtida da origem B também é sinalizada, mesmo quando a origem B lista a coluna.
Filtros de saída
Seção intitulada “Filtros de saída”
Para oferecer o máximo de flexibilidade, há filtros de dados tanto nos dados de origem quanto nos dados de destino. Em conjuntos de dados maiores, filtrar linhas na origem pode ser especialmente vantajoso, pois as demais operações são executadas sobre um conjunto de dados menor.
Selecionar subconjunto de dados
Este tipo de filtro permite filtrar os dados de origem de entrada com base nas condições especificadas.
Aplicar filtro secundário aos dados de resultado
Este tipo de filtro permite aplicar um filtro aos dados de resultado já transformados, com base nas condições especificadas. Aplicar um filtro ao resultado transformado permite fazer exclusões com base em resultados de cálculos complexos, sumarizações ou funções de janela.
Divisão final da tabela de dados (limite)
O recurso de divisão de linhas permite limitar as linhas do conjunto de resultados com base em um intervalo e um ponto de partida.
Sintaxe de filtro
A sintaxe de filtro usa o Python SQLAlchemy, a mesma sintaxe das outras expressões.
Veja exemplos e funções de expressão na área Expressões.