

Importar Planilha Google
Descrição
Seção intitulada “Descrição”Importa planilhas específicas de uma planilha do Planilhas Google para tabelas de projeto do PlaidCloud. Útil para dados ad hoc que ficam em planilhas — tabelas de direcionadores mantidas por usuários de negócio, mapeamentos de consulta, ajustes manuais.
A autenticação é feita por uma conexão Google; várias planilhas de uma mesma planilha do Google podem ser importadas em uma única etapa.
Exemplos
Seção intitulada “Exemplos”Ainda não há exemplos…
Parâmetros de importação
Seção intitulada “Parâmetros de importação”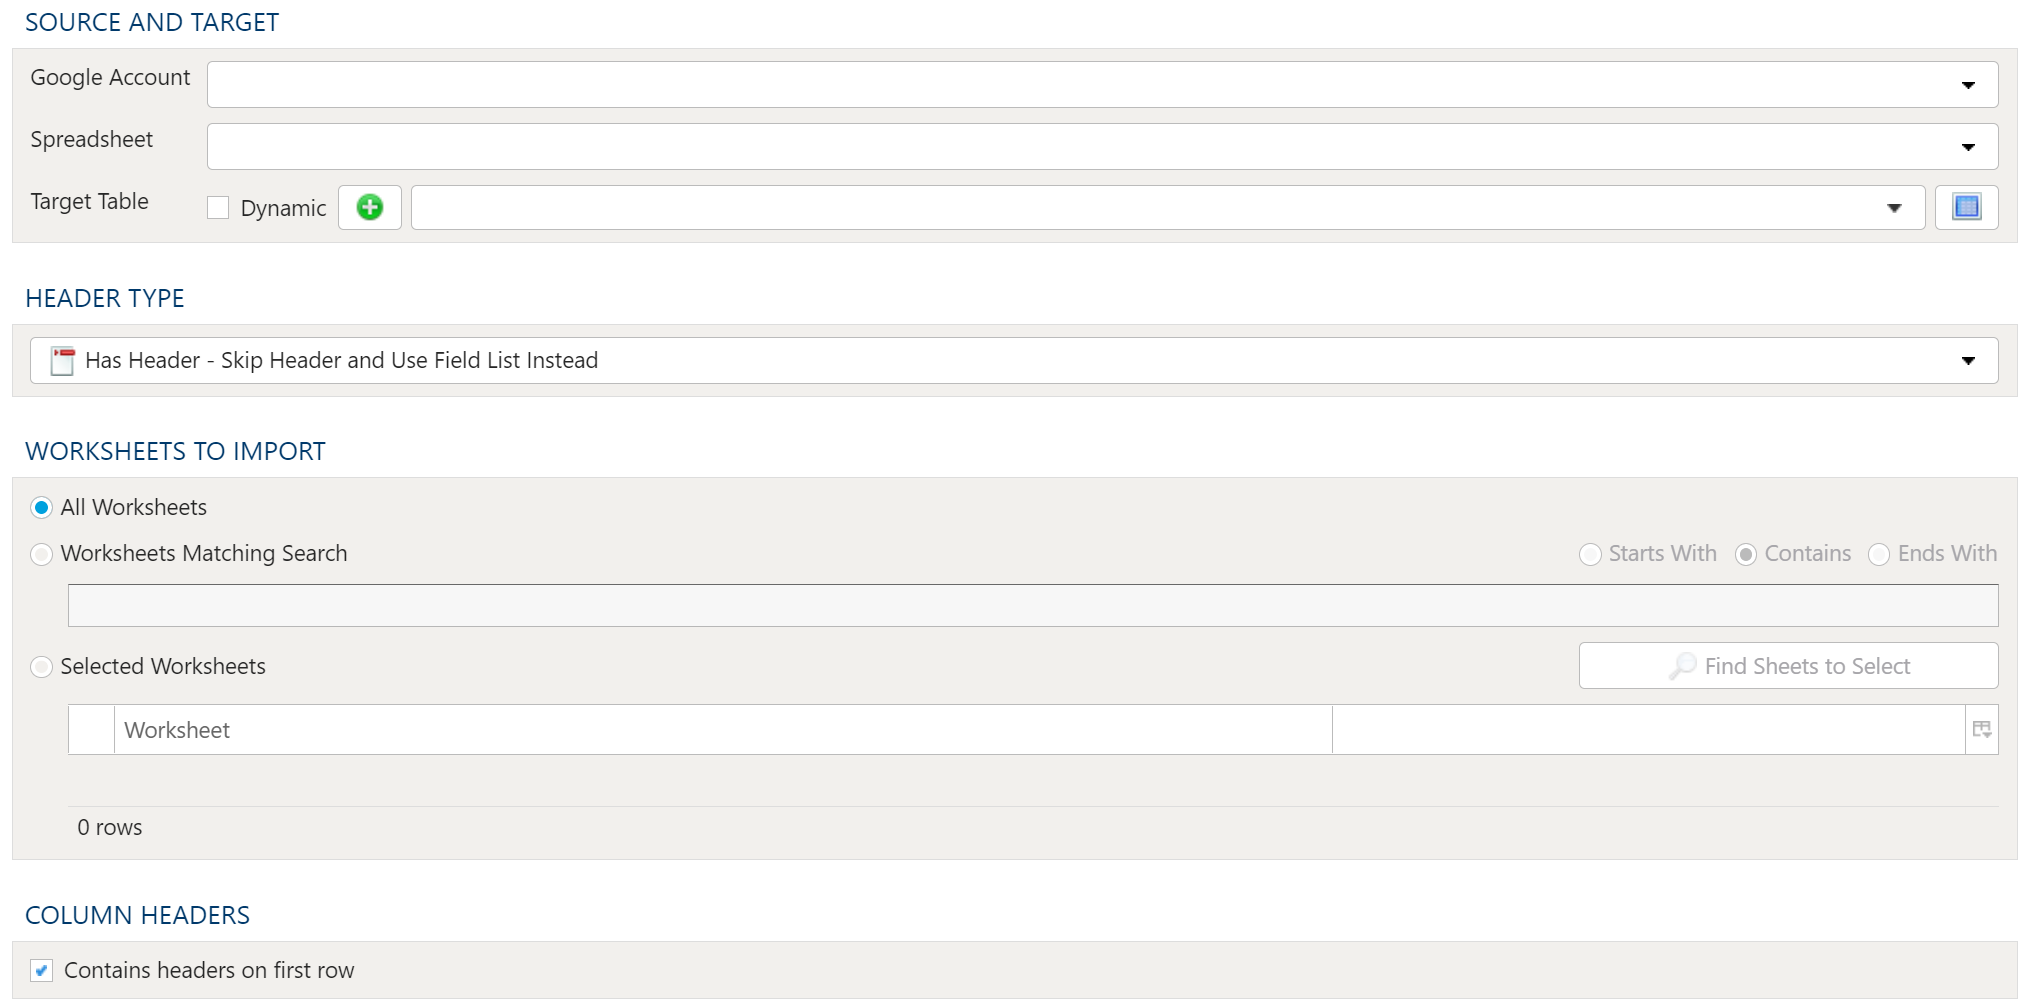
Origem e destino
Seção intitulada “Origem e destino”Conta Google
Seção intitulada “Conta Google”Acessar dados do Planilhas Google exige uma conta de usuário Google válida. Isso requer configuração em Ferramentas. Para detalhes sobre como configurar uma conexão de conta Google, veja aqui: PlaidCloud Tools – Conexão.
Depois que todas as contas necessárias estiverem configuradas, selecione a Conta Google apropriada na lista suspensa.
Planilha
Seção intitulada “Planilha”Em seguida, especifique a Planilha a ser importada no menu suspenso que contém todos os arquivos disponíveis associados à Conta Google especificada.
Tabela de destino
A seleção de destino para importações é limitada a tabelas, pois as visões não contêm dados subjacentes.
Opção dinâmica
A opção dinâmica permite especificar uma tabela por meio de texto, incluindo variáveis. Isso é útil ao usar fluxos de trabalho orientados por variáveis, nos quais as referências a tabelas e visões são relativas às variáveis especificadas.
Um exemplo que usa a variável current_month para apontar dinamicamente para a tabela de destino:
legal_entity/inputs/{current_month}/ledger_valuesOpção estática
Quando você quiser uma tabela específica como destino da importação, deixe a caixa Dinâmico desmarcada e selecione a tabela de destino.
Se a tabela de destino não existir, selecione o botão Criar novo para criar a tabela no local desejado.
O Explorador de tabelas está sempre disponível em qualquer seleção de tabela. Clique no botão Explorador de tabelas à direita da seleção de tabela e uma janela do Explorador de tabelas será aberta.
Tipo de cabeçalho
Seção intitulada “Tipo de cabeçalho”Como as Planilhas Google podem ou não conter cabeçalhos, o PlaidCloud oferece uma forma de usar os cabeçalhos, ignorá-los ou usar a ordem das colunas para determinar o alinhamento delas.
- Sem cabeçalho: o arquivo não contém cabeçalho. Use a lista de origem no Data Mapper para determinar o alinhamento das colunas
- Com cabeçalho - usar cabeçalho e substituir lista de campos: o arquivo tem cabeçalho. Use os nomes de cabeçalho especificados e ignore a lista de origem no Data Mapper.
- Com cabeçalho - ignorar cabeçalho e usar a lista de campos: o arquivo tem cabeçalho, mas ele deve ser ignorado. Use os nomes de cabeçalho especificados pela lista de origem no Data Mapper.
Planilhas a importar
Seção intitulada “Planilhas a importar”Como as pastas de trabalho podem conter muitas planilhas com dados diferentes, é possível selecionar quais planilhas devem ser importadas no processo de importação atual. As opções são:
- Todas as planilhas
- Planilhas correspondentes à pesquisa
- Planilhas selecionadas
Usando a pesquisa de planilhas
Seção intitulada “Usando a pesquisa de planilhas”A funcionalidade de pesquisa de planilhas permite incluir as planilhas que correspondem aos critérios de pesquisa. Os critérios de pesquisa permitem:
- Começa com: o nome da planilha começa com o texto pesquisado
- Contém: o nome da planilha contém o texto pesquisado
- Termina com: o nome da planilha termina com o texto pesquisado
Localizar abas no arquivo selecionado
Seção intitulada “Localizar abas no arquivo selecionado”O botão de localizar abas abre o arquivo Excel e lista as planilhas disponíveis na tabela. Marque as caixas de seleção na tabela das planilhas a serem incluídas na importação.
Cabeçalhos das colunas
Seção intitulada “Cabeçalhos das colunas”Seleção de dados da tabela
Seção intitulada “Seleção de dados da tabela”Configuração do Data Mapper
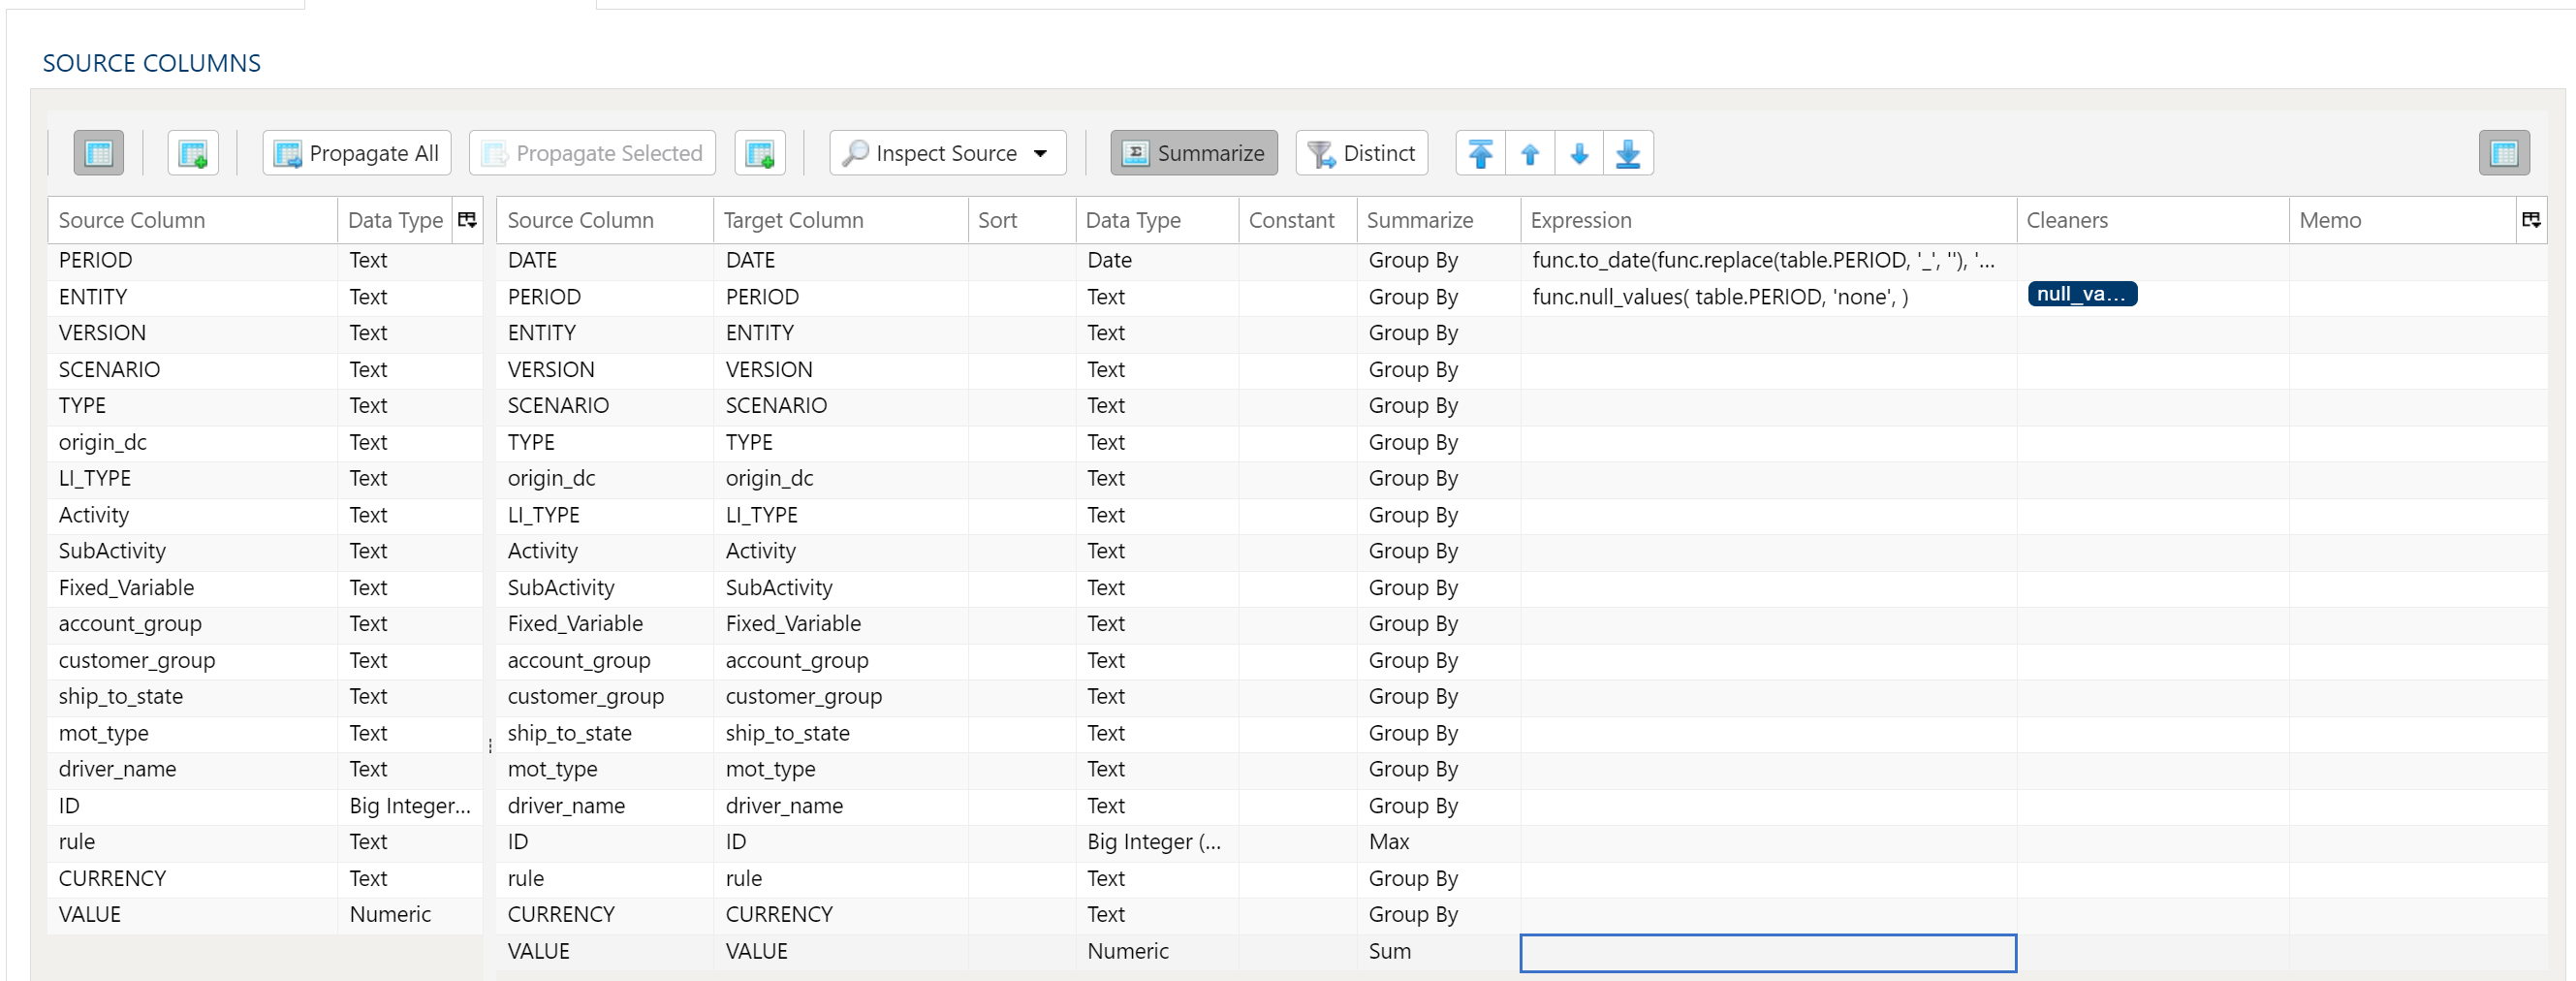
O Data Mapper é usado para mapear as colunas dos dados de origem para a tabela de dados de destino.
Inspeção e Preenchimento do Mapeador
O botão de menu Inspecionar origem oferece formas adicionais de mapear colunas da origem para o destino:
- Preencher ambas as tabelas de mapeamento: propaga todos os valores da tabela de dados de origem para a tabela de dados de destino. Este é o comportamento padrão.
- Preencher somente a tabela de mapeamento de origem: mapeia apenas todos os valores da tabela de dados de origem. Isso é útil ao modificar um fluxo de trabalho existente quando a estrutura de colunas da origem mudou.
- Preencher somente a tabela de mapeamento de destino: propaga todos os valores apenas para a tabela de dados de destino.
Se as opções de coluna de origem e de destino não forem suficientes, é possível adicionar outras colunas à tabela de dados de destino de várias maneiras:
- Propagar tudo insere todas as colunas de origem na tabela de dados de destino, quer elas já existam ou não.
- Propagar selecionadas insere apenas as colunas de origem selecionadas.
- Clique com o botão direito no lado do destino e selecione Inserir linha para inserir uma linha imediatamente acima da linha selecionada.
- Clique com o botão direito no lado do destino e selecione Anexar linha para inserir uma linha no final (extrema direita) da tabela de dados de destino.
Exclusão de Colunas
Para excluir colunas da tabela de dados de destino, selecione as colunas desejadas, clique com o botão direito e selecione Excluir.
Colunas de Origem que Não Estão Mais Listadas
Uma linha de destino pode indicar uma Coluna de origem que a tabela de dados de origem não lista mais, por exemplo depois que a origem foi inspecionada novamente. A etapa nunca remove essa linha por você. Em vez disso, o nome da coluna aparece em vermelho, após um sinal de aviso ⚠, e ao passar o mouse sobre ele é exibida a informação de que a coluna não está nas colunas de origem. Em uma etapa com várias tabelas, como uma união, cada tabela é verificada em relação às suas próprias colunas de origem.
Uma linha com resumo Constante, Expressão ou Contagem (incluindo nulos) nunca é sinalizada, porque a etapa não lê a coluna de origem dela. Nada é sinalizado enquanto a tabela de dados de origem não listar nenhuma coluna, por exemplo antes de a origem ser inspecionada pela primeira vez.
Ao salvar uma etapa que ainda tem linhas sinalizadas, uma caixa de diálogo Colunas obsoletas encontradas as lista sob a guia ou a tabela em que estão e oferece três opções:
- Remover todas e salvar — remove as linhas sinalizadas e, em seguida, salva.
- Salvar mesmo assim — salva a etapa como está.
- Cancelar — volta para a etapa sem salvar.
Para manter uma linha e eliminar o aviso dela, adicione a coluna de volta à tabela de dados de origem ou escolha uma coluna que a tabela de dados de origem liste.
Tipo de Dados da Coluna
Toda coluna de destino tem um Tipo. Uma coluna propagada da origem mantém o tipo da coluna de origem; uma linha que você adiciona manualmente começa como Texto, e você define o Tipo para indicar o que ela deve realmente ser — uma coluna que você pretende somar ou ordenar precisa do tipo numérico ou de data, porque texto é ordenado e somado como texto.
Uma etapa salva com uma coluna sem nenhum tipo ainda é executada. O tipo é determinado quando a etapa é iniciada, a partir da coluna de origem que essa coluna lê. Onde não há de onde lê-lo, ele é tratado como texto: as colunas de uma etapa Extrair SQL vêm da consulta que você escreveu, e não de uma origem mapeada, e onde várias origens têm o mesmo nome de coluna com tipos divergentes, usa-se texto em vez de adivinhar um deles — um palpite errado gera uma conversão que o data warehouse pode rejeitar, e qualquer coisa pode ser convertida em texto.
Definir o Tipo você mesmo continua sendo a forma de dizer o que uma coluna deve ser. Deixá-lo sem definição significa aceitar o tipo que a coluna de origem tiver.
Alteração da Ordem das Colunas
Para reorganizar as colunas na tabela de dados de destino, selecione as colunas desejadas. Você pode usar:
- Setas de movimentação em massa: selecione a opção de movimentação desejada nas setas no canto superior direito
- Menu de contexto: clique com o botão direito e selecione Mover para o início, Mover para cima, Mover para baixo ou Mover para o final.
Reduzir o Resultado a Registros Distintos
Para retornar apenas opções distintas, selecione a opção de menu Distintos. Isso exibe um conjunto de caixas de seleção para cada coluna da origem. Basta marcar a caixa ao lado da coluna correspondente para retornar apenas resultados distintos.
Dependendo da situação, talvez seja melhor considerar o uso de resumo.
O processo de distinção mantém o primeiro registro exclusivo encontrado e descarta os demais. Talvez você queira aplicar uma ordenação aos dados se a consistência entre execuções for importante.
Agregação e Agrupamento
Para agregar resultados, selecione a opção de menu Resumir. Isso exibe um conjunto de caixas de seleção para cada coluna da tabela de dados de destino. Escolha um método de resumo adequado para cada coluna.
Quando Inspecionar origem preenche as colunas, uma coluna numérica começa como Agrupar por em vez de Soma se o nome dela se parecer com um identificador, como id, customer_id, Order No ou CustomerKey, se a tabela dela a definir como chave ou se a junção a usar como chave.
- Agrupar por
- Soma
- Mínimo
- Máximo
- Primeiro
- Último
- Contagem
- Contagem (incluindo nulos)
- Média
- Desvio padrão
- Desvio padrão amostral
- Desvio padrão populacional
- Variância
- Variância amostral
- Variância populacional
- Avançado sem Agrupar por
Para uso avançado do Data Mapper, como expressões, limpeza e constantes, consulte Uso avançado do Data Mapper
Filtros de dados
Seção intitulada “Filtros de dados”
Para oferecer o máximo de flexibilidade, há filtros de dados tanto nos dados de origem quanto nos dados de destino. Em conjuntos de dados maiores, filtrar linhas na origem pode ser especialmente vantajoso, pois as demais operações são executadas sobre um conjunto de dados menor.
Selecionar subconjunto de dados
Este tipo de filtro permite filtrar os dados de origem de entrada com base nas condições especificadas.
Aplicar filtro secundário aos dados de resultado
Este tipo de filtro permite aplicar um filtro aos dados de resultado já transformados, com base nas condições especificadas. Aplicar um filtro ao resultado transformado permite fazer exclusões com base em resultados de cálculos complexos, sumarizações ou funções de janela.
Divisão final da tabela de dados (limite)
O recurso de divisão de linhas permite limitar as linhas do conjunto de resultados com base em um intervalo e um ponto de partida.
Sintaxe de filtro
A sintaxe de filtro usa o Python SQLAlchemy, a mesma sintaxe das outras expressões.
Veja exemplos e funções de expressão na área Expressões.