

Table Upsert 단계
일치 키로 지정한 하나 이상의 열을 기준으로 삽입과 업데이트를 하나의 작업으로 결합합니다. 소스의 각 행에 대해 대상에 일치하는 행(키 값이 같은 행)이 있으면 업데이트하고, 없으면 새 행을 삽입합니다.
신규 레코드와 기존 레코드의 수정 사항이 모두 포함된 증분 데이터 스트림(판매 업데이트, 직원 레코드 변경 등 “항상 최신 상태를 반영”해야 하는 시나리오)이 있을 때 사용하십시오. 일치 열은 신중하게 지정하십시오. 키 값은 같지만 다른 값이 다른 행은 덮어쓰이므로, 키를 잘못 선택하면 데이터가 조용히 손상될 수 있습니다.
업서트 매개변수
섹션 제목: “업서트 매개변수”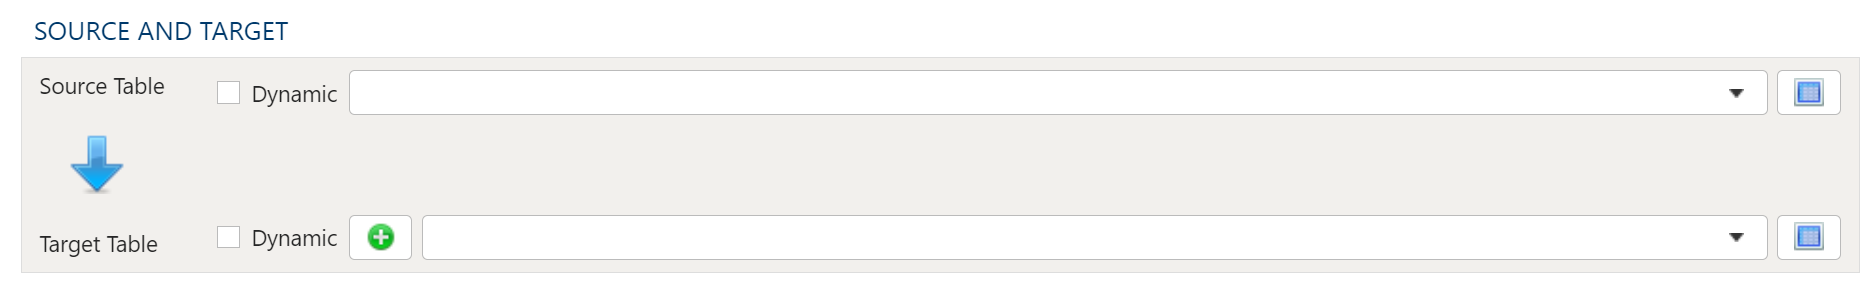
소스 테이블과 대상 테이블을 설정하려면 먼저 소스 테이블 드롭다운 메뉴에서 추출할 데이터 테이블을 선택합니다. 다음으로 대상 테이블 드롭다운에서 기존 테이블을 대상 테이블로 선택합니다.
소스 테이블 데이터 선택
섹션 제목: “소스 테이블 데이터 선택”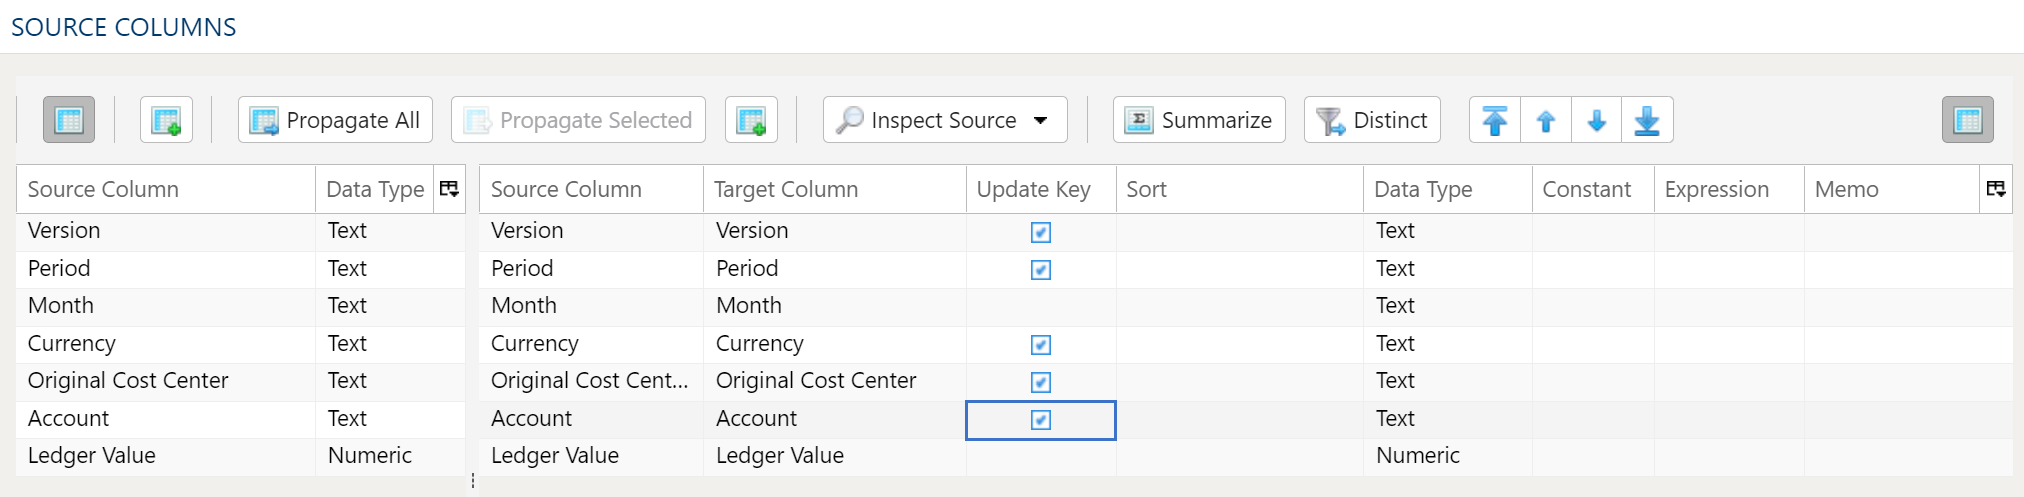
데이터 매퍼는 소스 데이터의 열을 대상 데이터 테이블에 매핑하는 데 사용합니다.
검사 및 매퍼 채우기
섹션 제목: “검사 및 매퍼 채우기”소스 검사 메뉴 버튼을 사용하면 소스에서 대상으로 열을 매핑하는 추가 방법을 사용할 수 있습니다.
- 두 매핑 테이블 모두 채우기: 소스 데이터 테이블의 모든 값을 대상 데이터 테이블로 전파합니다. 기본적으로 이렇게 수행됩니다.
- 소스 매핑 테이블만 채우기: 소스 데이터 테이블의 모든 값만 매핑합니다. 소스 열 구조가 변경되었을 때 기존 워크플로를 수정하는 경우에 유용합니다.
- 대상 매핑 테이블만 채우기: 모든 값을 대상 데이터 테이블에만 전파합니다.
소스 및 대상 열 옵션으로 충분하지 않으면 다른 열을 여러 방법으로 대상 데이터 테이블에 추가할 수 있습니다.
- 모두 전파는 이미 있는지 여부와 관계없이 모든 소스 열을 대상 데이터 테이블에 삽입합니다.
- 선택 항목 전파는 선택한 소스 열만 삽입합니다.
- 대상 쪽에서 마우스 오른쪽 버튼을 클릭하고 행 삽입을 선택하면 현재 선택한 행 바로 위에 행이 삽입됩니다.
- 대상 쪽에서 마우스 오른쪽 버튼을 클릭하고 행 추가를 선택하면 대상 데이터 테이블의 맨 아래(맨 오른쪽)에 행이 삽입됩니다.
열 삭제
섹션 제목: “열 삭제”대상 데이터 테이블에서 열을 삭제하려면 원하는 열을 선택한 다음 마우스 오른쪽 버튼을 클릭하고 삭제를 선택합니다.
열 순서 변경
섹션 제목: “열 순서 변경”대상 데이터 테이블에서 열을 재정렬하려면 원하는 열을 선택합니다. 다음 중 하나를 사용할 수 있습니다.
- 일괄 이동 화살표: 오른쪽 위의 화살표에서 원하는 이동 옵션을 선택합니다.
- 컨텍스트 메뉴: 마우스 오른쪽 버튼을 클릭하고 맨 위로 이동, 위로 이동, 아래로 이동 또는 맨 아래로 이동을 선택합니다.
결과를 고유한 레코드로만 줄이기
섹션 제목: “결과를 고유한 레코드로만 줄이기”고유한 옵션만 반환하려면 고유 메뉴 옵션을 선택합니다. 그러면 소스의 각 열에 대한 확인란 집합이 전환됩니다. 해당 열 옆의 확인란을 선택하면 해당 열 기준으로 고유한 결과만 반환됩니다.
상황에 따라 요약 사용을 대신 고려할 수도 있습니다.
고유 처리는 처음 발견한 고유 레코드를 유지하고 나머지는 버립니다. 실행 간 일관성이 중요하다면 데이터에 정렬을 적용하는 것이 좋습니다.
업데이트 키
섹션 제목: “업데이트 키”대상 열 그리드에는 대상 열 이름 바로 다음에 업데이트 키 열이 있습니다. 행을 함께 식별하는 열에 이 항목을 선택하십시오. 키 값이 대상에 이미 있는 행과 일치하는 소스 행은 해당 행을 업데이트하고, 그 밖의 소스 행은 삽입됩니다.
모든 열은 처음에 선택되어 있으므로, 키에 속하지 않는 열은 선택을 해제하십시오. 업데이트 키 설정이 없는 열(채우기로 방금 추가된 열이나 API로 설정 없이 저장된 열)은 키로 간주됩니다. 적어도 하나의 열은 선택된 상태로 남아 있어야 합니다.
소스 데이터 필터
섹션 제목: “소스 데이터 필터”
최대한의 유연성을 위해 데이터 필터는 소스 데이터와 대상 데이터 모두에서 사용할 수 있습니다. 대용량 데이터 세트에서는 소스에서 행을 먼저 걸러내어 나머지 작업을 더 작은 데이터 세트에서 수행하는 것이 특히 유용할 수 있습니다.
데이터 하위 집합 선택
이 필터 유형은 지정한 조건에 따라 들어오는 소스 데이터를 필터링합니다.
결과 데이터에 보조 필터 적용
이 필터 유형은 지정한 조건에 따라 변환된 후의 결과 데이터에 필터를 적용합니다. 변환 후 결과에 필터를 적용할 수 있으므로 복잡한 계산, 요약 또는 윈도우 함수의 결과를 기준으로 제외할 수 있습니다.
최종 데이터 테이블 분할(제한)
행 분할 기능을 사용하면 범위와 시작 지점에 따라 결과 집합의 행 수를 제한할 수 있습니다.
필터 구문
필터 구문은 다른 식과 동일한 구문인 Python SQLAlchemy를 사용합니다.
예제와 식 함수는 식 영역에서 확인하십시오.
저장할 때 검사하는 항목
섹션 제목: “저장할 때 검사하는 항목”- 업데이트 키가 하나 이상 있어야 합니다. 그렇지 않으면 저장이 거부되며 *At least one target column must be marked as Update Key.*라는 메시지가 표시됩니다.
- 매핑이 기존 대상 테이블과 일치해야 합니다. 대상 테이블이 이미 있으면, 단계는 테이블의 모든 열을 매핑해야 하고, 테이블에 없는 열은 매핑하지 않아야 하며, 각 열에 테이블의 형식을 지정해야 합니다. 이는 업서트가 테이블 열을 데이터와 함께 삭제하거나 열의 형식을 변경하지 못하도록 하기 위한 것입니다. 숫자와 통화는 같은 형식으로 간주됩니다. 거부 메시지에는 각 차이점이 표시됩니다. 예: The target columns must match the existing target table ‘customers’. The table has columns the step doesn’t map: region. 아직 없는 대상 테이블이나 변수로 이름을 지정한 대상 테이블은 단계를 실행할 때 검사합니다.
- 빈 매핑은 자동으로 채워집니다. 소스 테이블은 선택했지만 소스 열이나 대상 열이 없는 상태로 저장하면, 두 매핑 테이블 모두 채우기를 실행한 것처럼 소스에서 빈 쪽을 채웁니다.