

SQL 가져오기
외부 데이터베이스에 대한 SQL 쿼리 결과를 PlaidCloud 프로젝트 테이블로 가져옵니다. 쿼리는 원격 데이터베이스에서 실행되며 결과 집합만 PlaidCloud로 가져옵니다.
외부 데이터베이스 테이블 가져오기와 달리 SQL을 직접 작성합니다. 데이터가 PlaidCloud에 저장되기 전에 소스 데이터베이스가 수행하도록 하려는 복잡한 조인, 필터, 집계에 유용합니다.
가져오기 매개변수
섹션 제목: “가져오기 매개변수”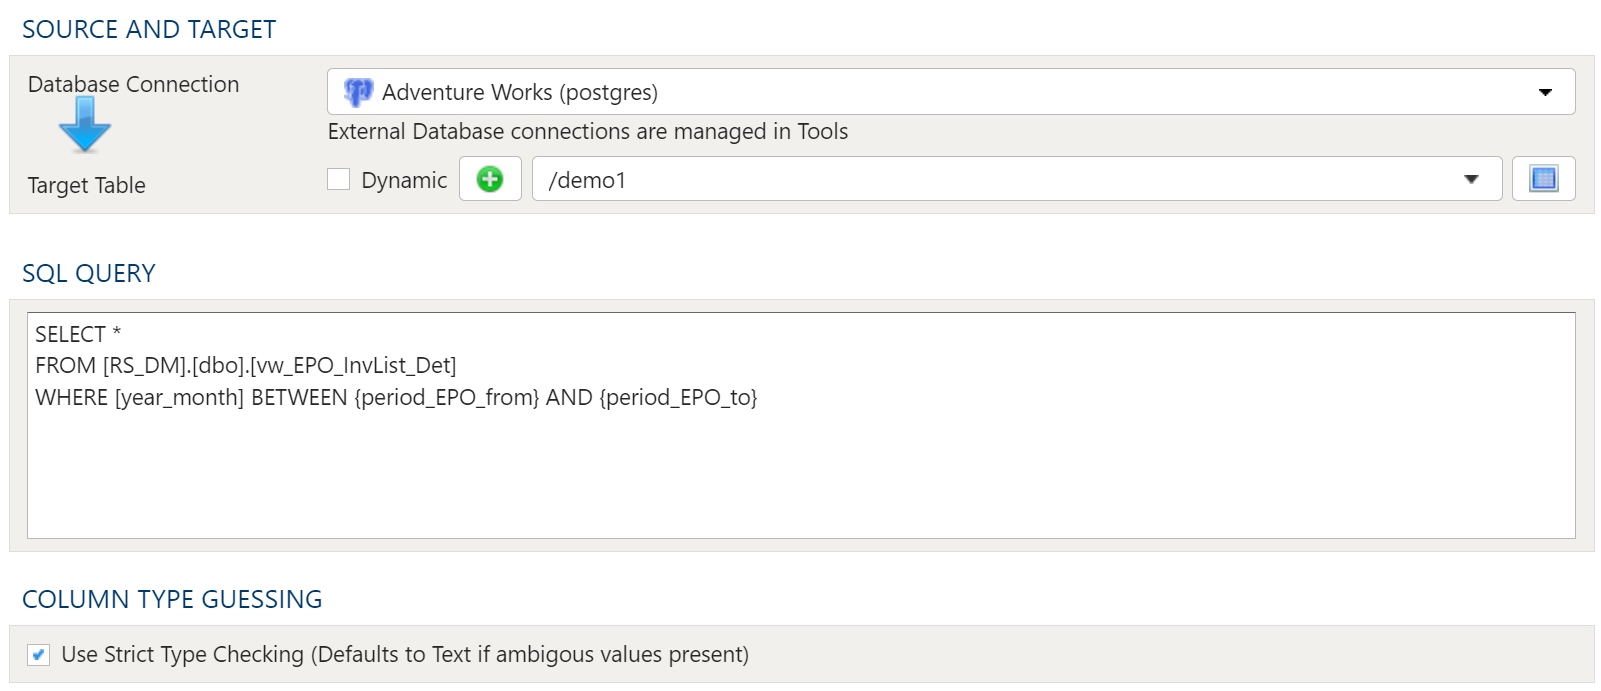
소스 및 대상
섹션 제목: “소스 및 대상”데이터베이스 연결
섹션 제목: “데이터베이스 연결”데이터베이스 연결을 설정하려면 PlaidCloud 데이터 연결을 참조하십시오.
대상 테이블
뷰에는 기본 데이터가 없으므로 가져오기의 대상은 테이블로만 제한됩니다.
동적 옵션
동적 옵션을 사용하면 변수를 포함한 텍스트로 테이블을 지정할 수 있습니다. 지정한 변수에 따라 테이블 및 뷰 참조가 달라지는 변수 기반 워크플로를 사용할 때 유용합니다.
current_month 변수를 사용하여 대상 테이블을 동적으로 가리키는 예는 다음과 같습니다.
legal_entity/inputs/{current_month}/ledger_values정적 옵션
가져오기의 대상으로 특정 테이블을 사용하려면 동적 체크박스를 선택하지 않은 상태로 두고 대상 테이블을 선택합니다.
대상 테이블이 없으면 새로 만들기 버튼을 선택하여 원하는 위치에 테이블을 만듭니다.
테이블 탐색기는 모든 테이블 선택에서 항상 사용할 수 있습니다. 테이블 선택 오른쪽의 테이블 탐색기 버튼을 클릭하면 테이블 탐색기 창이 열립니다.
SQL 쿼리
섹션 제목: “SQL 쿼리”이 섹션에서는 필요한 데이터를 반환하는 SQL 쿼리를 작성합니다.
열 유형 추측
섹션 제목: “열 유형 추측”SQL 가져오기에서는 로드 중에 데이터 유형을 추측하거나 모든 열을 텍스트 유형으로 설정할 수 있습니다. 데이터가 깨끗하다면 데이터 유형을 동적으로 설정하는 편이 더 빠를 수 있지만, 경우에 따라 문제가 발생할 수 있습니다.
예를 들어 데이터 대부분이 숫자로 보이지만 텍스트도 일부 섞여 있으면 숫자로 설정하려고 시도하여 데이터 유형 불일치로 인한 로드 문제가 발생할 수 있습니다. 또는 16자리 숫자 제품 코드가 있는 경우에도 문제가 생길 수 있습니다. 앞쪽의 0이 잘려 16자리 코드 대신 숫자가 됩니다.
그러나 데이터를 모두 텍스트로 설정하면, 텍스트가 아니어야 하는 데이터 유형을 날짜나 숫자 값 같은 적절한 유형으로 변환하기 위해 이후에 Extract 단계가 필요합니다.
문제 해결
섹션 제목: “문제 해결”| 증상 | 가능한 원인 |
|---|---|
| 쿼리, 연결, 데이터 양에는 다른 변화가 없는데 단계가 평소보다 눈에 띄게, 최대 약 30분 더 오래 걸렸습니다 | 가져오기를 실행하는 백그라운드 워커가 중간에 중단되었으며(워크플로가 원인이 아니라 플랫폼 측의 재시작 또는 제거), 플랫폼이 해당 테이블의 가져오기를 자동으로 다시 시도했습니다. 재시도는 중단이 감지된 후에야 시작되므로 추가 시간이 소요됩니다. |
| 그 지연 후에도 단계가 성공적으로 완료되었습니다 | 재시도는 테이블의 내용을 전부 교체하므로 결과는 한 번 깔끔하게 실행한 것과 같습니다. 추가로 확인하거나 다시 실행할 필요가 없습니다. |
| 단계가 “has already been attempted and cannot be safely re-run” 오류로 실패합니다 | SQL 가져오기 단계에서는 이 거부가 더 이상 발생하지 않으며, 실행 중 중단되면 대신 재시도합니다. 다만 프로젝트 아카이브 복원이나 차원 로드에서는 다시 실행하면 무언가를 교체하는 대신 중복이 생기므로, 의도적으로 이 오류가 계속 표시됩니다. SQL 가져오기 단계 자체에서 이 오류가 표시되면 지원 티켓을 여십시오. |