

Export External Database Tables 단계
파일이 아니라 연결을 통해 프로젝트 테이블을 외부 데이터베이스에 기록합니다. 모델링한 결과를 보고용 데이터베이스, 데이터 웨어하우스 또는 운영 시스템으로 되돌려 보낼 때 사용합니다.
외부 데이터베이스 테이블 가져오기의 반대 단계입니다. 한 단계에서 여러 테이블을 이동하며, 대상 테이블은 명시적으로 선택하거나 검색 패턴으로 일치시킬 수 있습니다.
고유 구성 항목
섹션 제목: “고유 구성 항목”대상 데이터베이스를 식별하는 데이터 연결입니다.
내보내기 유형
섹션 제목: “내보내기 유형”행을 기록하기 전에 각 대상 테이블을 준비하는 방식입니다.
- 추가만 — 기존 테이블에 행을 추가하며, 테이블이 없으면 실패합니다.
- 비우고 추가 — 테이블을 비우고 구조는 유지한 채 기록합니다.
- 만들고 추가 — 테이블이 없으면 만든 다음 기록합니다.
- 삭제, 만들기 후 추가 — 테이블을 삭제하고 다시 만든 다음 기록합니다. 소스 스키마가 변경된 경우에 사용합니다.
프레임 이름
섹션 제목: “프레임 이름”단계가 실행되는 프레임의 이름입니다.
대상 추가
섹션 제목: “대상 추가”대상 추가 및 제거 버튼을 사용하여 대상 테이블 목록을 만듭니다. 대상을 선택하면 오른쪽 창에서 구성할 수 있으며, 선택 항목 전환을 사용하여 선택한 대상의 내보내기를 사용하거나 사용하지 않도록 설정합니다. 내보내기는 대상 데이터베이스에서 테이블을 검색하지 않으므로 각 대상을 직접 추가하십시오. 외부 데이터베이스의 테이블을 찾으려면 외부 데이터베이스 테이블 가져오기 단계를 사용합니다.
대상 탭
섹션 제목: “대상 탭”선택한 대상에는 세 개의 탭이 있습니다.
소스 및 대상
섹션 제목: “소스 및 대상”내보낼 프로젝트 테이블과 저장될 위치를 선택합니다.
- 소스 — 특정 테이블은 프로젝트 테이블 하나를 지정하며, 실행 시점에 이름이 바뀌는 경우를 위한 동적 옵션이 있습니다. 검색과 일치하는 테이블은 검색 경로와 검색 텍스트로 찾은 모든 프로젝트 테이블을 내보내며, 정확히 일치, 시작 문자열, 포함 또는 끝 문자열 방식으로 일치시킵니다.
- 대상 외부 테이블 — 내보내기 사용은 대상을 켜거나 끕니다. 대상 스키마와 대상 테이블은 대상 테이블의 이름을 지정합니다. 원본 테이블과 같은 이름 사용은 각 소스 테이블의 이름을 그대로 사용합니다.
테이블 데이터 선택
섹션 제목: “테이블 데이터 선택”대상의 열 매퍼이며 전체 높이를 차지하는 별도의 탭입니다. 소스 검사는 프로젝트 소스 테이블의 열을 매퍼로 읽어 옵니다.
데이터 필터
섹션 제목: “데이터 필터”대상에 기록되는 행을 필터링합니다.
공통 구성 항목
섹션 제목: “공통 구성 항목”데이터 매퍼 구성
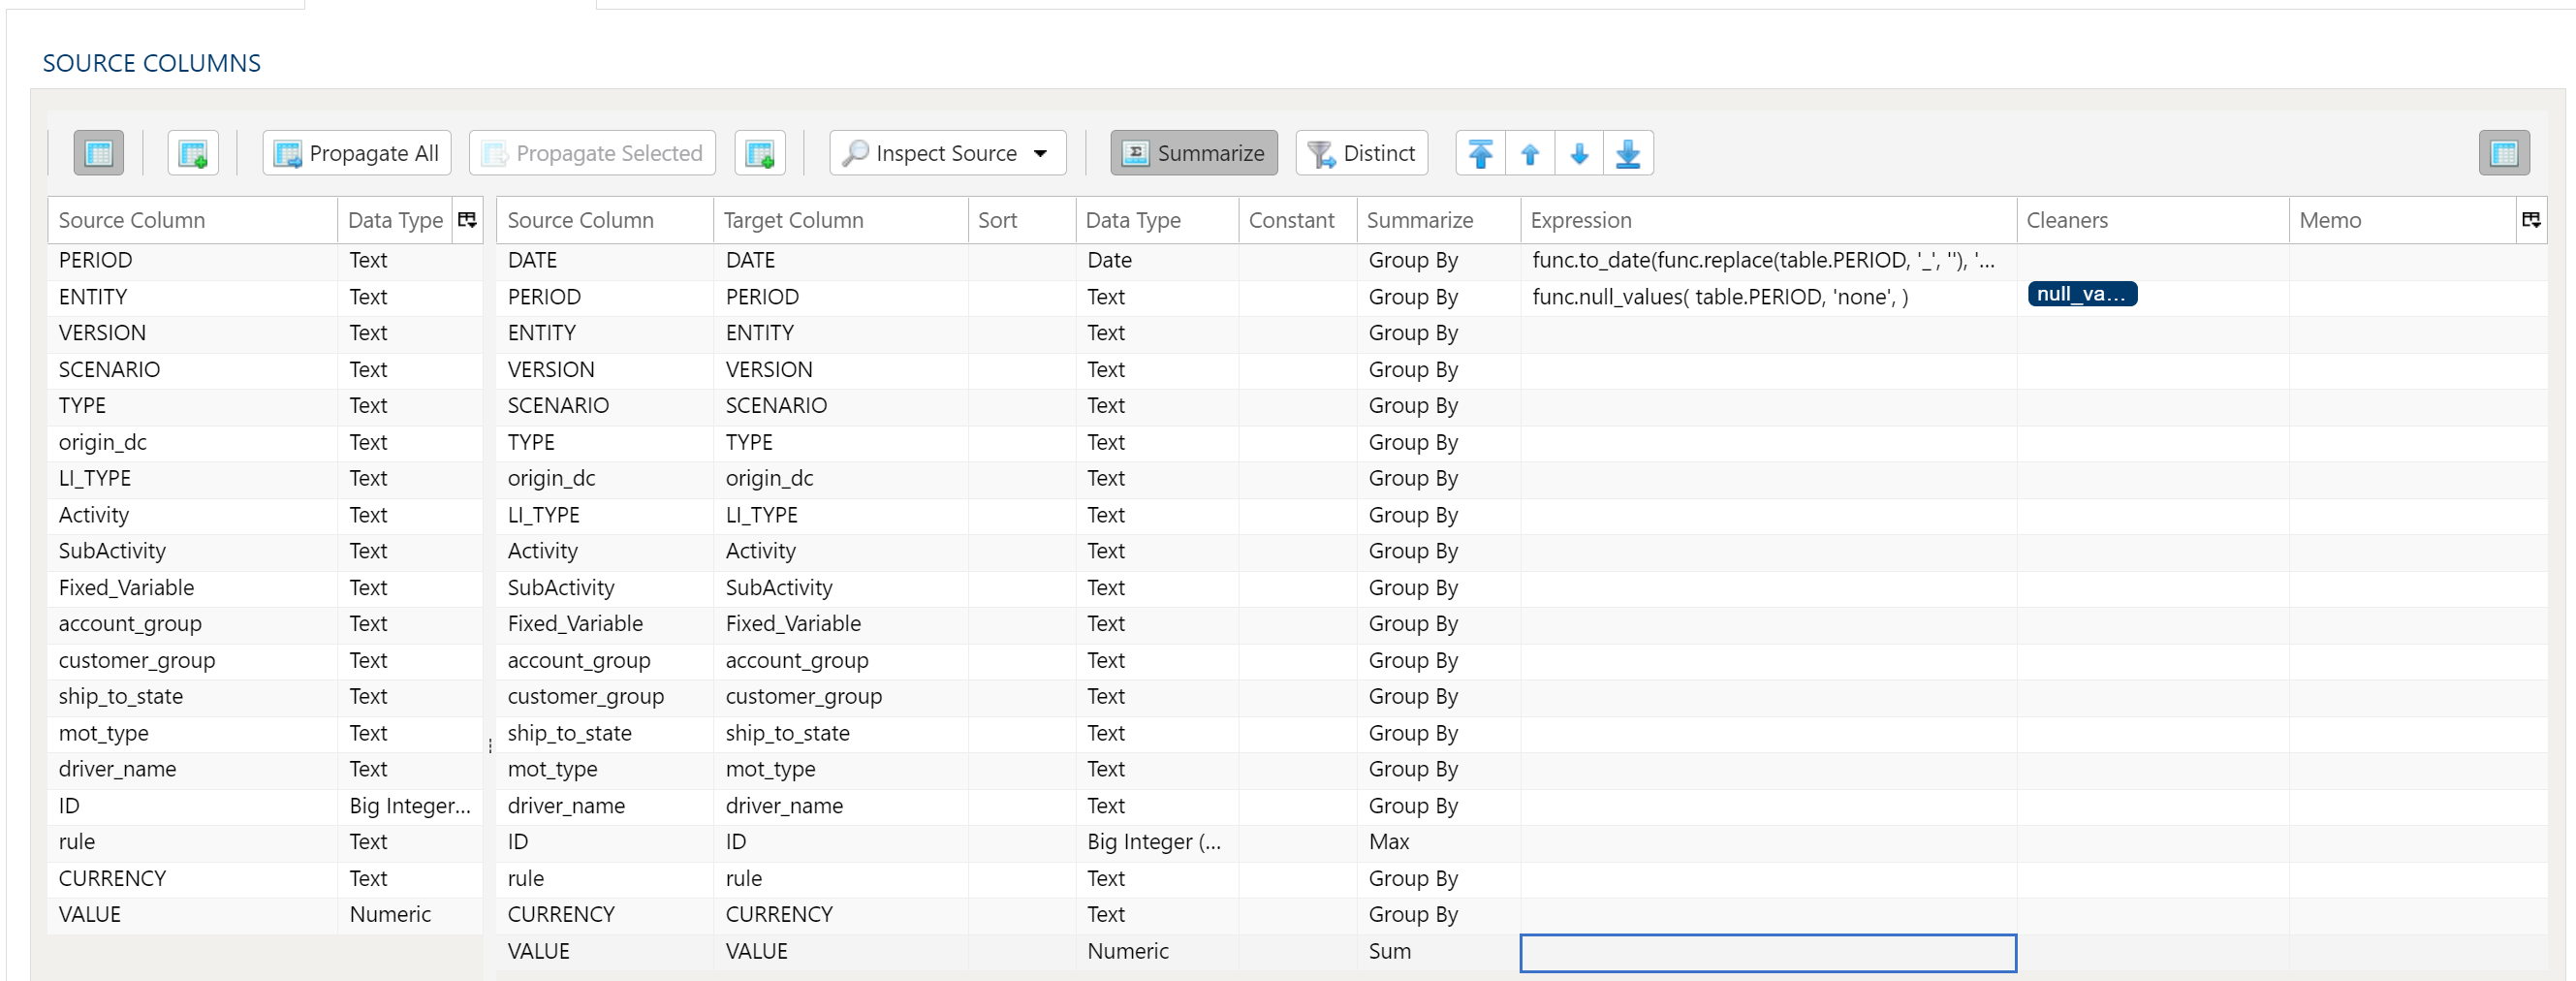
데이터 매퍼는 소스 데이터의 열을 대상 데이터 테이블에 매핑하는 데 사용합니다.
매퍼 검사 및 채우기
소스 검사 메뉴 버튼을 사용하면 소스에서 대상으로 열을 매핑하는 다양한 방법을 이용할 수 있습니다.
- 두 매핑 테이블 모두 채우기: 소스 데이터 테이블의 모든 값을 대상 데이터 테이블로 전파합니다. 기본적으로 이 방식이 적용됩니다.
- 소스 매핑 테이블만 채우기: 소스 데이터 테이블의 모든 값만 매핑합니다. 소스 열 구조가 변경된 상태에서 기존 워크플로를 수정할 때 유용합니다.
- 대상 매핑 테이블만 채우기: 모든 값을 대상 데이터 테이블에만 전파합니다.
소스 및 대상 열 옵션만으로 충분하지 않다면 다음과 같은 여러 방법으로 대상 데이터 테이블에 다른 열을 추가할 수 있습니다.
- 모두 전파는 이미 존재하는지 여부와 관계없이 모든 소스 열을 대상 데이터 테이블에 삽입합니다.
- 선택 항목 전파는 선택한 소스 열만 삽입합니다.
- 대상 쪽에서 마우스 오른쪽 버튼을 클릭하고 행 삽입을 선택하면 현재 선택한 행 바로 위에 행이 삽입됩니다.
- 대상 쪽에서 마우스 오른쪽 버튼을 클릭하고 행 추가를 선택하면 대상 데이터 테이블의 맨 아래(맨 오른쪽)에 행이 삽입됩니다.
열 삭제
대상 데이터 테이블에서 열을 삭제하려면 원하는 열을 선택한 다음 마우스 오른쪽 버튼을 클릭하고 삭제를 선택합니다.
더 이상 목록에 없는 소스 열
대상 행이 소스 데이터 테이블에 더 이상 나열되지 않는 소스 열을 지정하는 경우가 있습니다. 예를 들어 소스를 다시 검사한 후에 이런 일이 생길 수 있습니다. 단계는 이러한 행을 자동으로 제거하지 않습니다. 대신 열 이름이 ⚠ 경고 표시 뒤에 빨간색으로 표시되며, 마우스를 올리면 해당 열이 소스 열에 없다는 메시지가 나타납니다. 유니온처럼 여러 테이블을 사용하는 단계에서는 각 테이블을 해당 테이블의 소스 열과 비교하여 검사합니다.
상수, 식 또는 개수(null 포함) 요약이 지정된 행은 단계가 해당 소스 열을 읽지 않으므로 표시되지 않습니다. 소스 데이터 테이블에 열이 하나도 나열되지 않은 경우(예: 소스를 처음 검사하기 전)에도 아무것도 표시되지 않습니다.
표시된 행이 남아 있는 단계를 저장하면 오래된 열 발견 대화 상자가 해당 행을 각 행이 속한 탭 또는 테이블별로 나열하고 세 가지 선택지를 제공합니다.
- 모두 제거 후 저장 — 표시된 행을 제거한 다음 저장합니다.
- 그대로 저장 — 단계를 현재 상태 그대로 저장합니다.
- 취소 — 저장하지 않고 단계로 돌아갑니다.
행을 유지하면서 경고를 없애려면 해당 열을 소스 데이터 테이블에 다시 추가하거나 소스 데이터 테이블에 나열된 열을 선택하십시오.
열 데이터 유형
모든 대상 열에는 유형이 있습니다. 소스에서 전파된 열은 소스 열의 유형을 그대로 유지하고, 직접 추가한 행은 텍스트로 시작하므로 유형을 설정하여 실제로 필요한 유형을 지정해야 합니다. 합산하거나 정렬하려는 열에는 숫자 또는 날짜 유형이 필요합니다. 텍스트는 텍스트로 정렬되고 합산되기 때문입니다.
유형이 전혀 없는 열이 포함된 상태로 저장된 단계도 실행됩니다. 유형은 단계가 시작될 때 해당 열이 읽는 소스 열로부터 결정됩니다. 유형을 읽어 올 곳이 없으면 텍스트로 처리됩니다. SQL 추출 단계의 열은 매핑된 소스가 아니라 사용자가 작성한 쿼리에서 가져오며, 같은 열 이름이 서로 다른 유형으로 여러 소스에 있는 경우에는 그중 하나를 추측하지 않고 텍스트를 사용합니다. 잘못 추측하면 웨어하우스가 거부할 수 있는 변환이 발생하지만, 모든 값은 텍스트로 변환할 수 있기 때문입니다.
열이 어떤 유형이어야 하는지 지정하는 올바른 방법은 여전히 유형을 직접 설정하는 것입니다. 설정하지 않은 채 두면 소스 열이 어떤 유형이든 그대로 받아들이게 됩니다.
열 순서 변경
대상 데이터 테이블에서 열을 재정렬하려면 원하는 열을 선택합니다. 다음 두 가지 방법 중 하나를 사용할 수 있습니다.
- 일괄 이동 화살표: 오른쪽 위의 화살표에서 원하는 이동 옵션을 선택합니다.
- 컨텍스트 메뉴: 마우스 오른쪽 버튼을 클릭하고 맨 위로 이동, 위로 이동, 아래로 이동 또는 맨 아래로 이동을 선택합니다.
결과를 고유 레코드로만 줄이기
고유한 항목만 반환하려면 고유 메뉴 옵션을 선택합니다. 그러면 소스의 각 열마다 체크박스 집합이 표시됩니다. 고유한 결과만 반환하려면 해당 열 옆의 상자를 선택하기만 하면 됩니다.
상황에 따라서는 요약을 대신 사용하는 것이 좋을 수 있습니다.
고유 처리는 처음 발견된 고유 레코드를 유지하고 나머지는 버립니다. 실행 간 일관성이 중요하다면 데이터에 정렬을 적용하는 것이 좋습니다.
집계 및 그룹화
결과를 집계하려면 요약 메뉴 옵션을 선택합니다. 그러면 대상 데이터 테이블의 각 열마다 선택 상자가 표시됩니다. 각 열에 적절한 요약 방법을 선택합니다.
소스 검사로 열을 채울 때, 숫자 열은 이름이 id, customer_id, Order No, CustomerKey처럼 식별자로 읽히거나, 테이블에서 키로 설정되어 있거나, 조인에서 키로 사용되는 경우 합계 대신 그룹화 기준으로 시작합니다.
- 그룹화 기준
- 합계
- 최소
- 최대
- 처음
- 마지막
- 개수
- 개수(null 포함)
- 평균
- 표준 편차
- 표본 표준 편차
- 모집단 표준 편차
- 분산
- 표본 분산
- 모집단 분산
- 고급 Non-Group_By
식, 정리, 상수 등 데이터 매퍼의 고급 사용법은 고급 데이터 매퍼 사용법을 참조하십시오.

최대한의 유연성을 위해 데이터 필터는 소스 데이터와 대상 데이터 모두에서 사용할 수 있습니다. 대용량 데이터 세트에서는 소스에서 행을 먼저 걸러내어 나머지 작업을 더 작은 데이터 세트에서 수행하는 것이 특히 유용할 수 있습니다.
데이터 하위 집합 선택
이 필터 유형은 지정한 조건에 따라 들어오는 소스 데이터를 필터링합니다.
결과 데이터에 보조 필터 적용
이 필터 유형은 지정한 조건에 따라 변환된 후의 결과 데이터에 필터를 적용합니다. 변환 후 결과에 필터를 적용할 수 있으므로 복잡한 계산, 요약 또는 윈도우 함수의 결과를 기준으로 제외할 수 있습니다.
최종 데이터 테이블 분할(제한)
행 분할 기능을 사용하면 범위와 시작 지점에 따라 결과 집합의 행 수를 제한할 수 있습니다.
필터 구문
필터 구문은 다른 식과 동일한 구문인 Python SQLAlchemy를 사용합니다.
예제와 식 함수는 식 영역에서 확인하십시오.