Allocation By Assignment Dimension 단계
할당 차원과 드라이버 데이터 테이블을 기준으로 소스 테이블의 값을 대상에 배부합니다. 가장 유연한 배부 단계로, 각 소스 행의 목적지는 계층이 결정하고 얼마가 어디로 가는지는 드라이버 값이 결정하는 드라이버 기반 배분에 사용합니다.
일반적인 패턴: 활동 시간을 사용하여 원가 센터 합계를 제품 라인에 배분하기, 인원수를 기준으로 IT 간접비를 사업부에 분배하기, 사용자 지정 가중치를 사용하여 공유 서비스 비용을 배부하기.
데이터 테이블 설정
섹션 제목: “데이터 테이블 설정”할당 차원 계층
섹션 제목: “할당 차원 계층”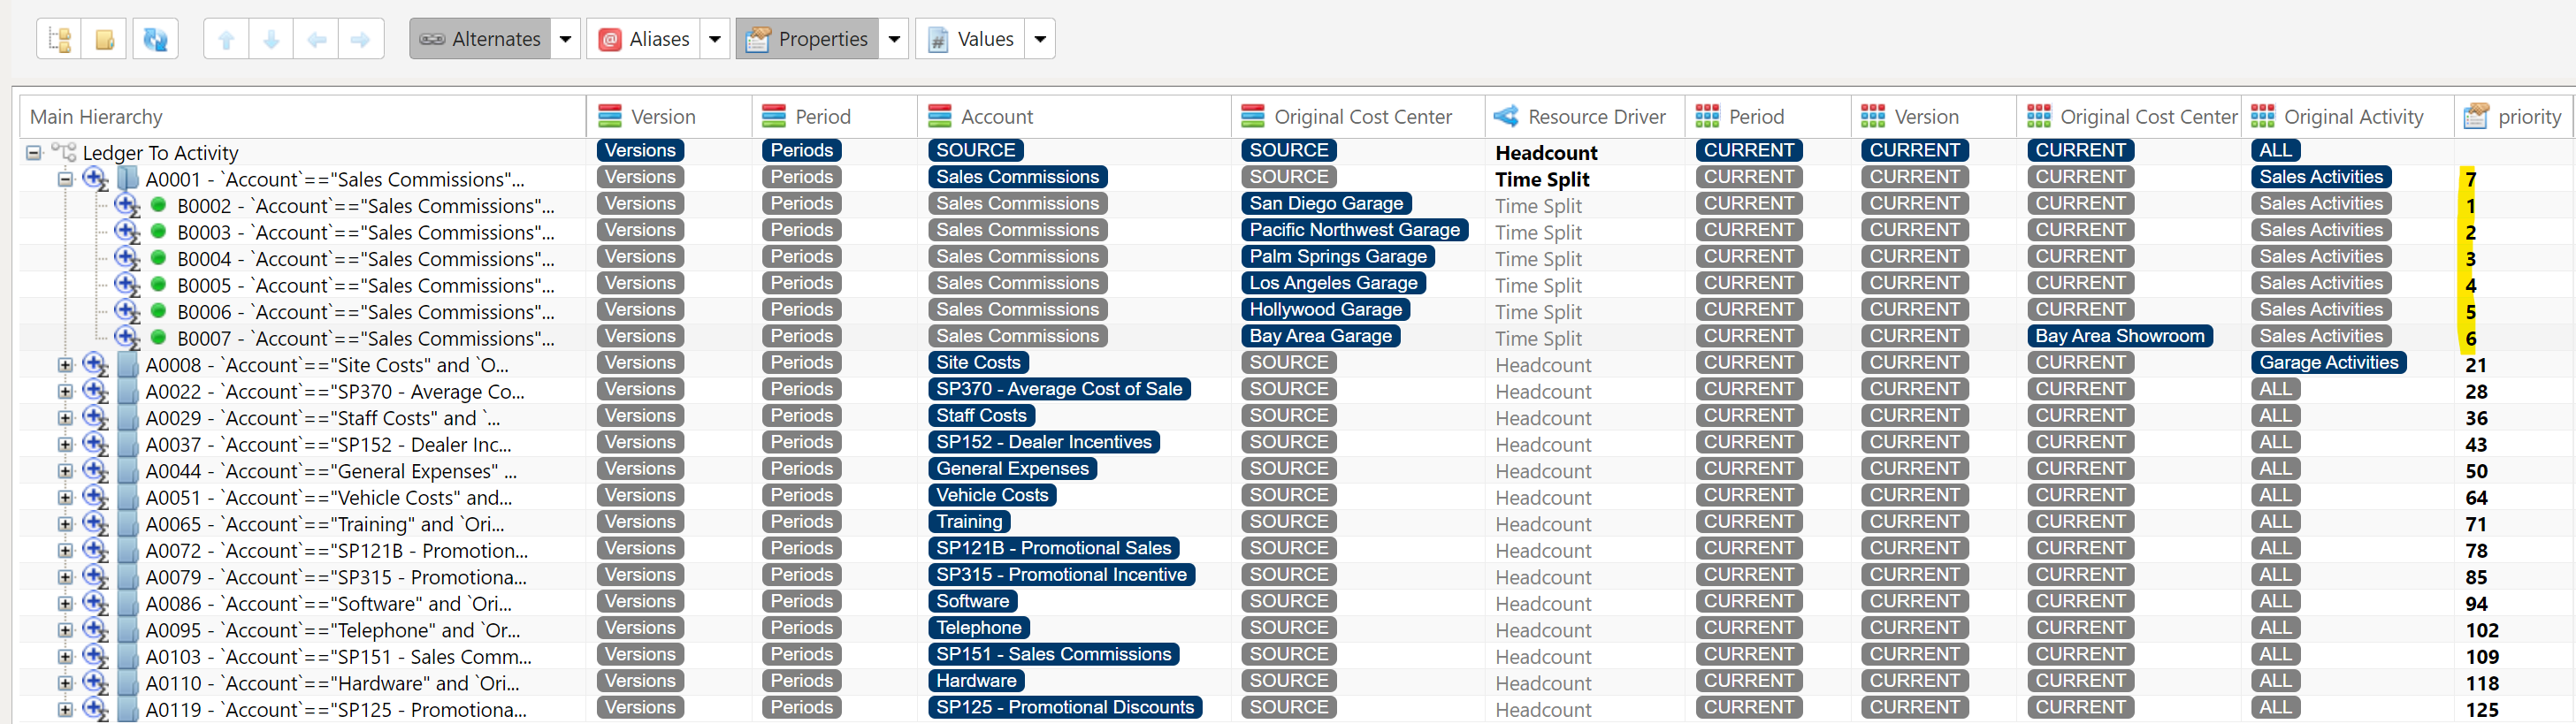
할당 차원 계층을 사용하면 배부할 값 테이블과 드라이버 데이터 테이블 중 하나 또는 둘 모두를 지정하고 클릭하여 필터링함으로써 대상 지정 배부를 만들 수 있습니다. 할당 차원 계층은 배부할 값 테이블과 드라이버 데이터 테이블을 참조하는 차원을 조합하여 만듭니다.
할당 차원 계층 만들기
섹션 제목: “할당 차원 계층 만들기”할당 차원 계층을 만들려면 먼저 배부할 값 테이블과 드라이버 데이터 테이블의 필터로 사용할 차원을 만들어야 합니다. 아래 링크에서 이러한 차원을 만드는 방법을 안내합니다.
기본 계층 만들기
섹션 제목: “기본 계층 만들기”배부할 값 테이블과 드라이버 데이터 테이블의 차원을 만들었다면, 다음 단계는 배부할 값 테이블의 차원 중 어느 것을 할당 차원 계층의 기본 계층으로 사용할지 결정하는 것입니다.
PlaidCloud의 차원 탭으로 이동하여 차원을 클릭한 다음 작업과 차원 복사를 선택하여 이 차원을 복사합니다. 차원을 복사하면 복사된 차원의 이름을 입력하라는 팝업이 나타납니다.
할당 계층에 차원 추가
섹션 제목: “할당 계층에 차원 추가”새로 만든 할당 차원을 열고 속성 옆의 아래쪽 화살표를 클릭한 다음 새 속성을 선택합니다.
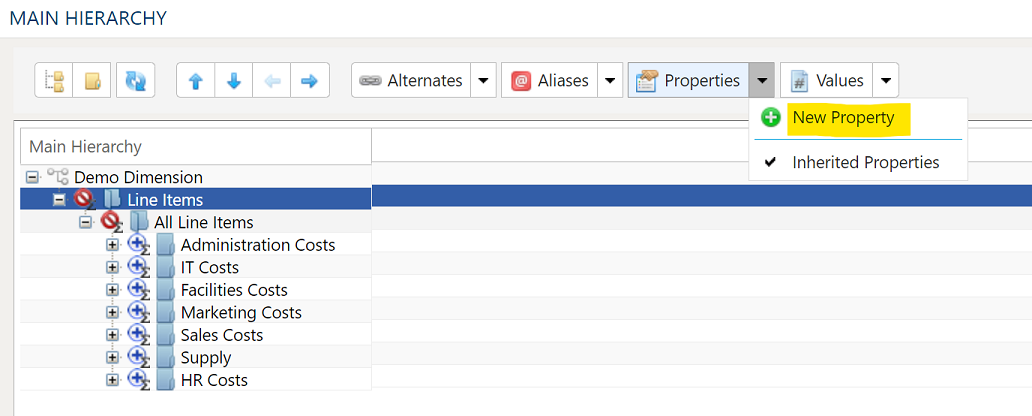
그러면 속성 구성 대화 상자가 열립니다.
속성 구성
섹션 제목: “속성 구성”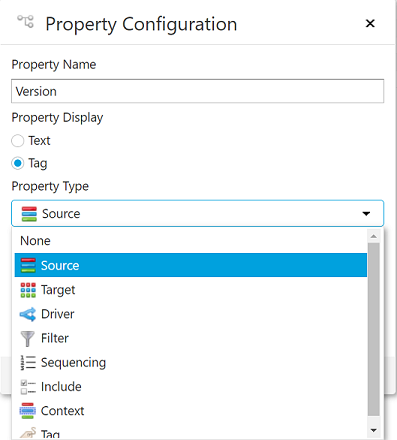
- 속성 이름 - 보통 할당 계층에 추가하는 차원의 이름입니다.
- 속성 표시 - “Tag”로 설정해야 합니다.
- 속성 유형 - 이 차원이 배부할 값 테이블과 드라이버 데이터 테이블 중 어느 테이블과 관련되는지를 배부 단계에 알려 줍니다.
- 소스 - 배부할 값 테이블과 함께 사용합니다.
- 대상 - 드라이버 데이터 테이블과 함께 사용합니다.
- 드라이버 - 선택한 특정 드라이버로 드라이버 데이터 테이블을 필터링하는 데 사용합니다.
- 컨텍스트 - 배부할 값 테이블과 드라이버 데이터 테이블에 같은 차원이 있을 때, 컨텍스트를 사용하여 차원이 서로 어떻게 연관되어야 하는지 지정할 수 있습니다. 컨텍스트는 배부할 값 테이블과 드라이버 데이터 테이블에 모두 이익/원가 센터 또는 _지역_이 있을 때 자주 사용합니다.
- Left blank - 자체 컨텍스트가 없는 노드는 컨텍스트를 설정한 가장 가까운 상위 노드의 컨텍스트를 따르므로, 빈 셀은 _컨텍스트 없음_이 아니라 _상속_을 뜻합니다. 어떤 상위 노드도 컨텍스트를 설정하지 않은 경우에만 드라이버 데이터 테이블이 대상 차원 자체의 설정으로 필터링되는 것으로 되돌아갑니다.
- 현재 - 통과 역할을 하며 대상 차원의 설정에 따라 드라이버 데이터 테이블을 필터링합니다. 예를 들어 컨텍스트가 이익 센터 차원을 기준으로 하고 이익 센터 대상 차원이 모두로 설정되어 있으면, 드라이버 데이터는 모든 _이익 센터_를 기준으로 필터링됩니다. 저장된 값이므로 위에서 설명한 상속도 막습니다. 따라서 상위 노드가 컨텍스트를 설정한 경우 현재는 노드가 “여기에는 컨텍스트 없음”이라고 말하는 방법입니다. 대신 셀을 비우면 노드가 상위 노드의 컨텍스트를 물려받게 됩니다.
- Parent - 선택하면 배부할 값 테이블에 있는 _이익 센터_의 상위 항목이 드라이버 데이터 테이블의 드라이버 값을 필터링하는 데 사용됩니다. 특정 _이익 센터_의 드라이버 값은 없지만 상위 수준에는 있는 경우가 많을 때 유용합니다.
- 모두 - 선택하면 배부할 값 테이블의 _이익 센터_가 드라이버 데이터 테이블의 드라이버 값을 필터링하지 않으며, 모든 _이익 센터_의 드라이버 값이 사용됩니다.
- 할당되지 않음 - 대상 차원이 선택했을 드라이버 행 대신, _이익 센터_에 값이 전혀 없거나
UNASSIGNED(대/소문자 구분 없음)인 행만 사용되며, _이익 센터_가 결과를 분할하지 않습니다. 어떤 _이익 센터_도 소유하지 않는 비용을 분배하는 규칙에 사용합니다. 이를 설정한 규칙에만 적용되며, 같은 열을 비워 두는 다른 규칙에는 영향을 주지 않습니다.
- 편집기 유형 - 이 드롭다운은 Select Dimension으로 설정해야 합니다.
할당 계층에 추가하는 차원의 적절한 속성을 선택했다면 “구성 편집”을 선택합니다.
차원 구성
섹션 제목: “차원 구성”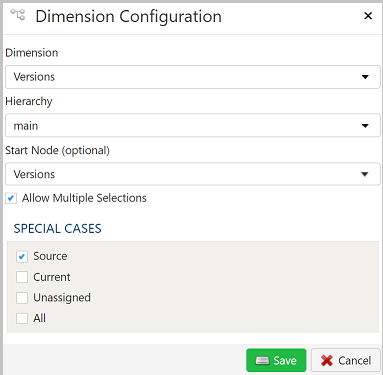
- 차원 - 드롭다운을 사용하여 차원을 선택합니다.
- 계층 - 선택한 차원에 대체 계층이 있으면 기본 계층과 함께 여기에 표시되어 선택할 수 있습니다.
- Start Node - 차원을 최상위 노드부터 표시하지 않으려면 계층 내의 임의 노드를 차원이 표시될 시작 노드로 선택할 수 있습니다.
- 여러 항목 선택 허용 - 선택하면 사용자가 계층에서 여러 노드를 선택할 수 있습니다.
- 특수 사례 - 선택하면 차원 드롭다운 메뉴에서 특수 사례를 선택할 수 있습니다. 보통 대상 차원에서 사용합니다.
- 소스 - 차원이 _소스_로 설정되면 배부는 드라이버 데이터 테이블을 필터링할 때 이 차원을 무시하지만, 배부 결과에는 해당 차원의 값이 포함됩니다.
- 현재 - _소스_와 _대상_이 차원을 공유할 때 사용할 수 있습니다. 대상 차원이 현재로 설정되면 배부가 실행되는 동안 드라이버 데이터 테이블이 소스 차원의 현재 값으로 필터링됩니다. 예를 들어 배부할 값 테이블과 드라이버 데이터 테이블에 여러 기간이 있는데 기간을 가로질러서가 아니라 기간 안에서 배부하려는 경우가 있습니다. 현재는 사업부, 원가 센터, _지역_에도 자주 사용합니다.
- 할당되지 않음 - 차원이 _할당되지 않음_으로 설정되면 배부는 드라이버 데이터 테이블을 필터링할 때 이 차원을 무시하며, 이 차원의 배부 결과는 Null 값이 됩니다.
- 모두 - 차원이 _ALL_로 설정되면 배부는 차원의 모든 값을 사용합니다.
배부할 값 테이블, 드라이버 데이터 테이블, 배부 결과 테이블은 동적 또는 정적으로 선택할 수 있습니다.
동적 테이블 선택
섹션 제목: “동적 테이블 선택”동적 테이블 옵션을 사용하면 텍스트와 변수로 테이블을 지정할 수 있습니다. 테이블 또는 뷰 참조가 지정한 변수에 따라 달라지는 변수 기반 워크플로를 사용할 때 유용합니다.
current_month 변수를 사용하여 테이블을 동적으로 가리키는 예:
legal_entity/inputs/{current_month}/ledger_values정적 테이블 선택
섹션 제목: “정적 테이블 선택”특정 테이블을 소스로 사용하려면 Dynamic 상자를 선택하지 않은 채로 두고 드롭다운 메뉴에서 소스 테이블을 선택합니다.
테이블 탐색기는 모든 테이블 선택에서 항상 사용할 수 있습니다. 테이블 선택 오른쪽에 있는 테이블 탐색기 버튼을 클릭하면 테이블 탐색기 창이 열립니다.
배부할 값 테이블
섹션 제목: “배부할 값 테이블”배부할 값이 들어 있는 테이블입니다. 보통 비용 또는 수익 값입니다.
드라이버 데이터 테이블
섹션 제목: “드라이버 데이터 테이블”드라이버 데이터 테이블에는 배부 단계가 비용을 배부하는 데 사용할 값이 들어 있습니다.
예:
- 공급망에서 고객에게 비용을 할당하려면 배송 건수나 배송 중량을 드라이버로 하는 배송 데이터를 사용할 수 있습니다.
- IT 헬프 데스크가 지원하는 부서에 비용을 할당하려면 드라이버 데이터는 원가 센터별 티켓 수가 됩니다.
Driver Data Sign Rule
섹션 제목: “Driver Data Sign Rule”드라이버 데이터에는 양수와 음수가 모두 포함될 수 있습니다. Driver Data Sign Rule을 사용하면 부호가 충돌할 때의 처리 방식을 정할 수 있습니다.
- Error on conficting signs - 부호 충돌이 발견되면 배부 단계가 오류를 내고 중지합니다.
- Proceed with warning on conflicting signs - 배부 단계가 음수와 양수 드라이버 값을 모두 사용하되 경고를 표시합니다.
- Use only positive driver values - 배부 단계가 양수 드라이버 값만 사용하고 음수 값은 무시합니다.
- Use only negative driver values - 배부 단계가 음수 드라이버 값만 사용하고 양수 값은 무시합니다.
- Use absolute values of driver data - 배부 단계가 드라이버 데이터의 절댓값을 사용합니다.
레코드를 둘 이상의 규칙에 일치시키기
섹션 제목: “레코드를 둘 이상의 규칙에 일치시키기”기본적으로 레코드는 처음으로 일치하는 규칙 하나만 적용합니다. 레코드를 하나의 규칙에만 일치를 선택 해제하면 일치하는 모든 규칙을 적용합니다. 이 경우 레코드는 일치하는 규칙마다 한 번씩 나타나며, 어떤 규칙에도 일치하지 않는 레코드는 제외됩니다.
규칙은 시퀀싱 유형의 할당 차원 속성으로 반복 단위로 나눌 수도 있으며, 이 속성의 값은 각 규칙이 실행되는 반복입니다. 레코드를 하나의 규칙에만 일치를 선택 해제한 단계는 두 가지를 함께 할 수 없습니다. 실행되는 규칙이 둘 이상의 반복에 걸쳐 있으면 단계는 Cannot apply rules when there are multiple iterations and records can match more than one rule 메시지와 함께 중지됩니다. 이 옵션을 선택하거나 각 반복을 별도의 단계로 실행하십시오.
중간 테이블
섹션 제목: “중간 테이블”_중간 테이블_은 배부 단계가 실행될 때마다 만들어지며 배부 처리의 요약을 제공합니다. _중간 테이블_은 배부 프로세스가 어떻게 실행되는지 파악하게 해 주며 예상치 못한 결과를 문제 해결하는 데 사용됩니다.
- 경로 - 할당 계층에서 요약된 고유 배부 경로의 수를 보여 줍니다.
- 매핑 - 배부할 값 테이블의 각 행이 배부 대상에 어떻게 매핑되는지 보여 줍니다.
- 요약 - 할당 계층의 결과로 나온 각 규칙과 배부할 값 테이블의 레코드 중 몇 건이 그 규칙에 일치하는지 보여 줍니다.
레코드를 하나의 규칙에만 일치를 선택한 상태에서 어떤 규칙에도 일치하지 않는 레코드는 매핑 테이블에서 규칙 열이 비어 있으며, 규칙 이름이 없는 요약 행에 집계됩니다. 규칙이 비워 둔 값도 비어 있습니다. 비어 있다는 것은 빈 문자열이 아니라 null을 뜻하며, Pandas가 아닌 SQL을 사용하여 규칙 적용의 선택 여부와 관계없이 세 테이블의 열과 유형은 동일합니다.
배부 결과 테이블
섹션 제목: “배부 결과 테이블”결과를 대상 테이블에 추가
섹션 제목: “결과를 대상 테이블에 추가”이 상자를 선택하면 배부 결과가 배부 결과 테이블에 추가됩니다. 이 상자를 선택하지 않으면 배부 단계가 실행될 때마다 배부 결과 테이블을 덮어씁니다.
배부 결과용 별도 열
섹션 제목: “배부 결과용 별도 열”이 상자를 선택하면 결과 테이블에 각 배부 레코드의 금액과 각 드라이버 레코드에 실제로 배부된 금액이 함께 표시됩니다.
차원 노드 이름 바꾸기
섹션 제목: “차원 노드 이름 바꾸기”이 상자를 선택하면 배부 단계가 실행될 때 할당 차원의 차원 노드 이름을 바꿉니다.
고급 옵션
섹션 제목: “고급 옵션”스레드 수
섹션 제목: “스레드 수”배부 단계가 사용할 동시 작업의 수를 설정합니다.
청크 크기
섹션 제목: “청크 크기”스레드 하나에서 처리할 배부 경로의 수를 설정합니다.
배부 소스 맵
섹션 제목: “배부 소스 맵”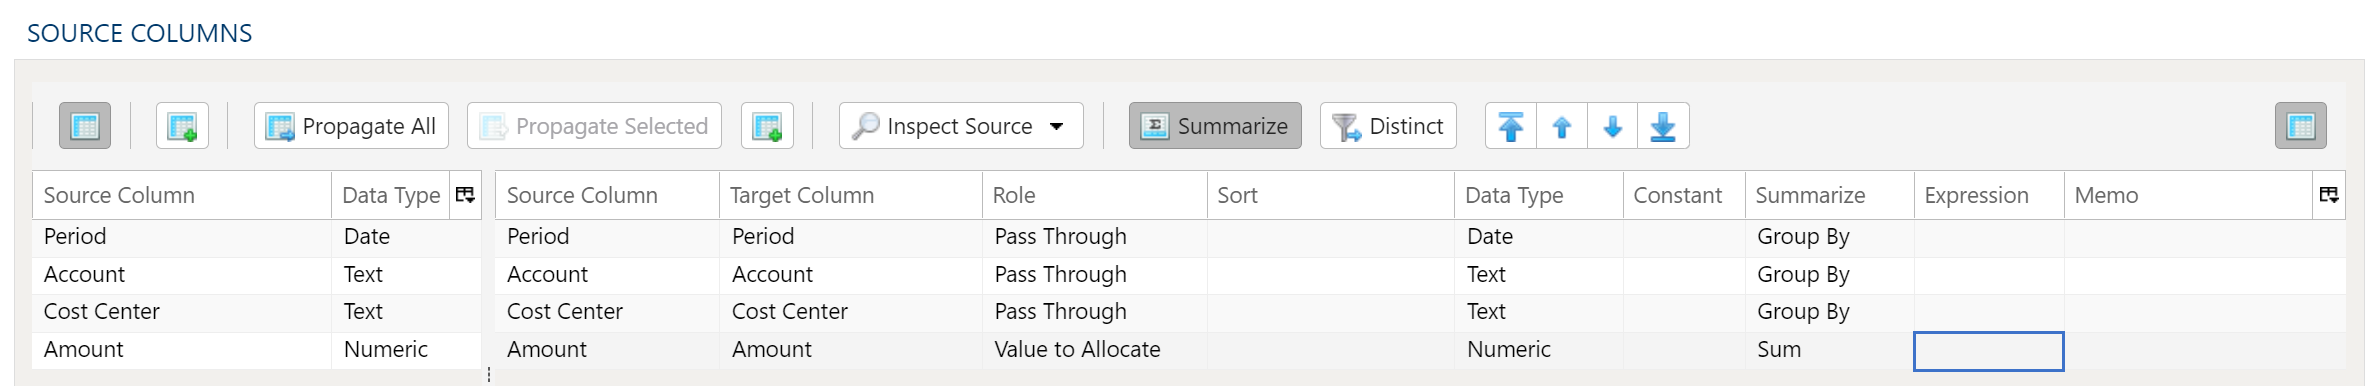
배부 소스 맵은 배부 단계에서 사용할 배부할 값 테이블의 열을 매핑하는 데 사용합니다.
소스 검사 및 매퍼 채우기
소스 검사 메뉴 버튼을 사용하면 소스에서 대상으로 열을 매핑하는 추가 방법을 사용할 수 있습니다.
- 두 매핑 테이블 모두 채우기: 소스 데이터 테이블의 모든 값을 대상 데이터 테이블로 전파합니다. 기본으로 적용되는 동작입니다.
- 소스 매핑 테이블만 채우기: 소스 데이터 테이블의 모든 값만 매핑합니다. 소스 열 구조가 변경되어 기존 워크플로를 수정할 때 유용합니다.
- 대상 매핑 테이블만 채우기: 모든 값을 대상 데이터 테이블로만 전파합니다.
소스 및 대상 열 옵션만으로 충분하지 않은 경우 다음과 같은 여러 방법으로 대상 데이터 테이블에 다른 열을 추가할 수 있습니다.
- 모두 전파는 이미 존재하는지 여부와 관계없이 모든 소스 열을 대상 데이터 테이블에 삽입합니다.
- 선택 항목 전파는 선택한 소스 열만 삽입합니다.
- 대상 쪽에서 마우스 오른쪽 버튼을 클릭하고 행 삽입을 선택하면 현재 선택한 행 바로 위에 행이 삽입됩니다.
- 대상 쪽에서 마우스 오른쪽 버튼을 클릭하고 행 추가를 선택하면 대상 데이터 테이블의 맨 아래(맨 오른쪽)에 행이 삽입됩니다.
역할
데이터 매퍼의 각 열에는 역할을 지정해야 합니다.
- Pass Thought - 이 열은 배부 결과 테이블에 표시됩니다.
- 배부할 값 - 배부할 값이 들어 있는 열입니다.
열 삭제
대상 데이터 테이블에서 열을 삭제하려면 삭제할 열을 선택한 다음 마우스 오른쪽 버튼을 클릭하고 삭제를 선택합니다.
열 순서 변경
대상 데이터 테이블에서 열을 재정렬하려면 이동할 열을 선택합니다. 다음 중 하나를 사용할 수 있습니다.
- 일괄 이동 화살표: 오른쪽 위의 화살표에서 원하는 이동 옵션을 선택합니다.
- 컨텍스트 메뉴: 마우스 오른쪽 버튼을 클릭하고 맨 위로 이동, 위로 이동, 아래로 이동 또는 맨 아래로 이동을 선택합니다.
결과를 고유 레코드로만 줄이기
고유한 옵션만 반환하려면 고유 메뉴 옵션을 선택합니다. 소스의 각 열에 대한 체크박스 집합이 표시됩니다. 고유한 결과만 반환할 열 옆의 체크박스를 선택하면 됩니다.
상황에 따라서는 요약을 대신 사용하는 것이 나을 수 있습니다.
고유 처리는 처음 발견한 고유 레코드를 유지하고 나머지는 버립니다. 실행 간 일관성이 중요하다면 데이터에 정렬을 적용하는 것이 좋습니다.
집계 및 그룹화
결과를 집계하려면 요약 메뉴 옵션을 선택합니다. 대상 데이터 테이블의 각 열에 대한 선택 상자 집합이 표시됩니다. 각 열에 적절한 요약 방법을 선택합니다.
- 그룹화 기준
- 합계
- 최솟값
- 최댓값
- 첫 번째
- 마지막
- 개수
- 개수(null 포함)
- 평균
- 표준 편차
- 표본 표준 편차
- 모집단 표준 편차
- 분산
- 표본 분산
- 모집단 분산
- 고급 비그룹화(Non-Group_By)
식, 정리, 상수 등 데이터 매퍼의 고급 사용법은 고급 데이터 매퍼 사용법을 참조하십시오.
배부 소스 필터
섹션 제목: “배부 소스 필터”
최대한의 유연성을 위해 데이터 필터는 소스 데이터와 대상 데이터 모두에서 사용할 수 있습니다. 대용량 데이터 세트에서는 소스에서 행을 먼저 걸러내어 나머지 작업을 더 작은 데이터 세트에서 수행하는 것이 특히 유용할 수 있습니다.
데이터 하위 집합 선택
이 필터 유형은 지정한 조건에 따라 들어오는 소스 데이터를 필터링합니다.
결과 데이터에 보조 필터 적용
이 필터 유형은 지정한 조건에 따라 변환된 후의 결과 데이터에 필터를 적용합니다. 변환 후 결과에 필터를 적용할 수 있으므로 복잡한 계산, 요약 또는 윈도우 함수의 결과를 기준으로 제외할 수 있습니다.
최종 데이터 테이블 분할(제한)
행 분할 기능을 사용하면 범위와 시작 지점에 따라 결과 집합의 행 수를 제한할 수 있습니다.
필터 구문
필터 구문은 다른 식과 동일한 구문인 Python SQLAlchemy를 사용합니다.
예제와 식 함수는 식 영역에서 확인하십시오.
드라이버 데이터 맵
섹션 제목: “드라이버 데이터 맵”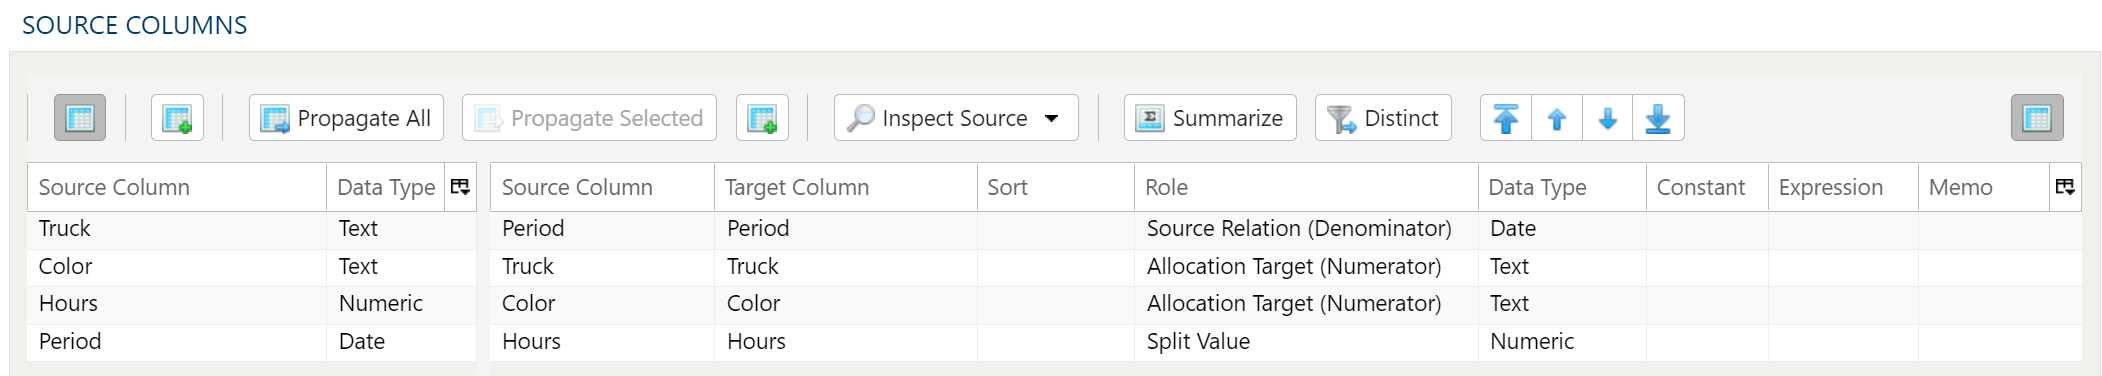
배부 드라이버 데이터 맵은 배부 단계에서 사용할 드라이버 데이터 테이블의 열을 매핑하는 데 사용합니다.
소스 검사 및 매퍼 채우기
소스 검사 메뉴 버튼을 사용하면 소스에서 대상으로 열을 매핑하는 추가 방법을 사용할 수 있습니다.
- 두 매핑 테이블 모두 채우기: 소스 데이터 테이블의 모든 값을 대상 데이터 테이블로 전파합니다. 기본으로 적용되는 동작입니다.
- 소스 매핑 테이블만 채우기: 소스 데이터 테이블의 모든 값만 매핑합니다. 소스 열 구조가 변경되어 기존 워크플로를 수정할 때 유용합니다.
- 대상 매핑 테이블만 채우기: 모든 값을 대상 데이터 테이블로만 전파합니다.
소스 및 대상 열 옵션만으로 충분하지 않은 경우 다음과 같은 여러 방법으로 대상 데이터 테이블에 다른 열을 추가할 수 있습니다.
- 모두 전파는 이미 존재하는지 여부와 관계없이 모든 소스 열을 대상 데이터 테이블에 삽입합니다.
- 선택 항목 전파는 선택한 소스 열만 삽입합니다.
- 대상 쪽에서 마우스 오른쪽 버튼을 클릭하고 행 삽입을 선택하면 현재 선택한 행 바로 위에 행이 삽입됩니다.
- 대상 쪽에서 마우스 오른쪽 버튼을 클릭하고 행 추가를 선택하면 대상 데이터 테이블의 맨 아래(맨 오른쪽)에 행이 삽입됩니다.
역할
데이터 매퍼의 각 열에는 역할을 지정해야 합니다.
- Source Relation - 이 열은 배부할 값 테이블에 대응하는 열이 있습니다.
- Allocation Target - 이 열은 배부 단계의 대상이 되며 배부 결과 테이블에 표시됩니다.
- 분할 값 - 이 열에는 배부할 값 테이블의 값을 배부하는 데 사용할 값이 들어 있습니다.
열 삭제
대상 데이터 테이블에서 열을 삭제하려면 삭제할 열을 선택한 다음 마우스 오른쪽 버튼을 클릭하고 삭제를 선택합니다.
열 순서 변경
대상 데이터 테이블에서 열을 재정렬하려면 이동할 열을 선택합니다. 다음 중 하나를 사용할 수 있습니다.
- 일괄 이동 화살표: 오른쪽 위의 화살표에서 원하는 이동 옵션을 선택합니다.
- 컨텍스트 메뉴: 마우스 오른쪽 버튼을 클릭하고 맨 위로 이동, 위로 이동, 아래로 이동 또는 맨 아래로 이동을 선택합니다.
결과를 고유 레코드로만 줄이기
고유한 옵션만 반환하려면 고유 메뉴 옵션을 선택합니다. 소스의 각 열에 대한 체크박스 집합이 표시됩니다. 고유한 결과만 반환할 열 옆의 체크박스를 선택하면 됩니다.
상황에 따라서는 요약을 대신 사용하는 것이 나을 수 있습니다.
고유 처리는 처음 발견한 고유 레코드를 유지하고 나머지는 버립니다. 실행 간 일관성이 중요하다면 데이터에 정렬을 적용하는 것이 좋습니다.
집계 및 그룹화
결과를 집계하려면 요약 메뉴 옵션을 선택합니다. 대상 데이터 테이블의 각 열에 대한 선택 상자 집합이 표시됩니다. 각 열에 적절한 요약 방법을 선택합니다.
- 그룹화 기준
- 합계
- 최솟값
- 최댓값
- 첫 번째
- 마지막
- 개수
- 개수(null 포함)
- 평균
- 표준 편차
- 표본 표준 편차
- 모집단 표준 편차
- 분산
- 표본 분산
- 모집단 분산
- 고급 비그룹화(Non-Group_By)
식, 정리, 상수 등 데이터 매퍼의 고급 사용법은 고급 데이터 매퍼 사용법을 참조하십시오.
드라이버 데이터 필터
섹션 제목: “드라이버 데이터 필터”
최대한의 유연성을 위해 데이터 필터는 소스 데이터와 대상 데이터 모두에서 사용할 수 있습니다. 대용량 데이터 세트에서는 소스에서 행을 먼저 걸러내어 나머지 작업을 더 작은 데이터 세트에서 수행하는 것이 특히 유용할 수 있습니다.
데이터 하위 집합 선택
이 필터 유형은 지정한 조건에 따라 들어오는 소스 데이터를 필터링합니다.
결과 데이터에 보조 필터 적용
이 필터 유형은 지정한 조건에 따라 변환된 후의 결과 데이터에 필터를 적용합니다. 변환 후 결과에 필터를 적용할 수 있으므로 복잡한 계산, 요약 또는 윈도우 함수의 결과를 기준으로 제외할 수 있습니다.
최종 데이터 테이블 분할(제한)
행 분할 기능을 사용하면 범위와 시작 지점에 따라 결과 집합의 행 수를 제한할 수 있습니다.
필터 구문
필터 구문은 다른 식과 동일한 구문인 Python SQLAlchemy를 사용합니다.
예제와 식 함수는 식 영역에서 확인하십시오.
예제 1
섹션 제목: “예제 1”배부할 값 테이블
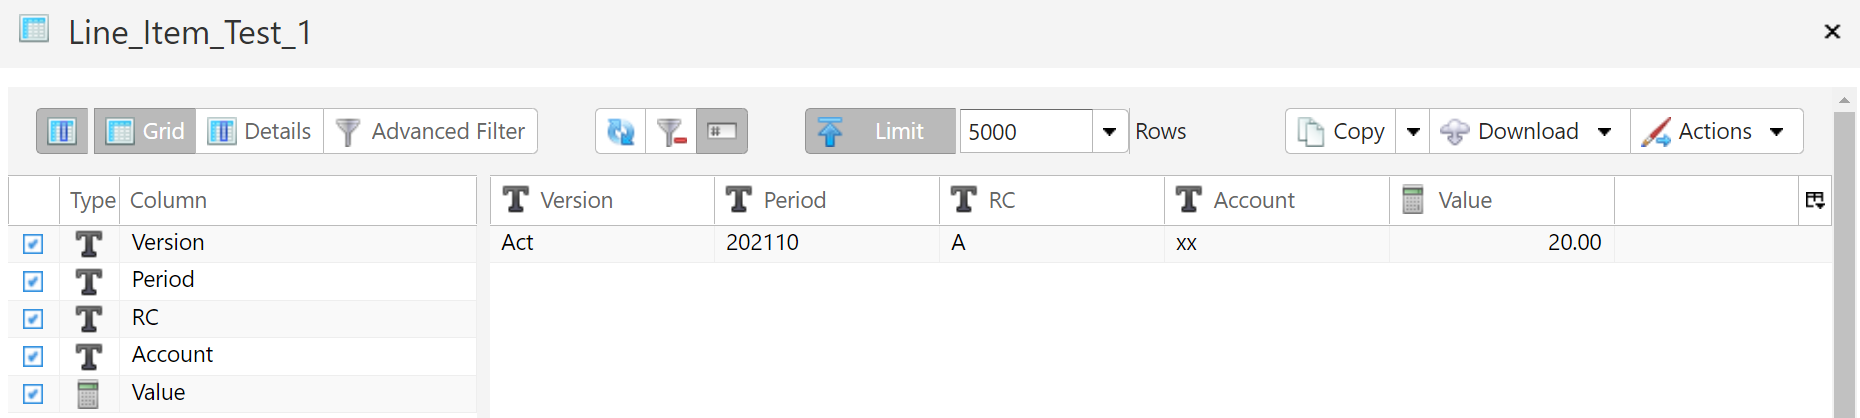
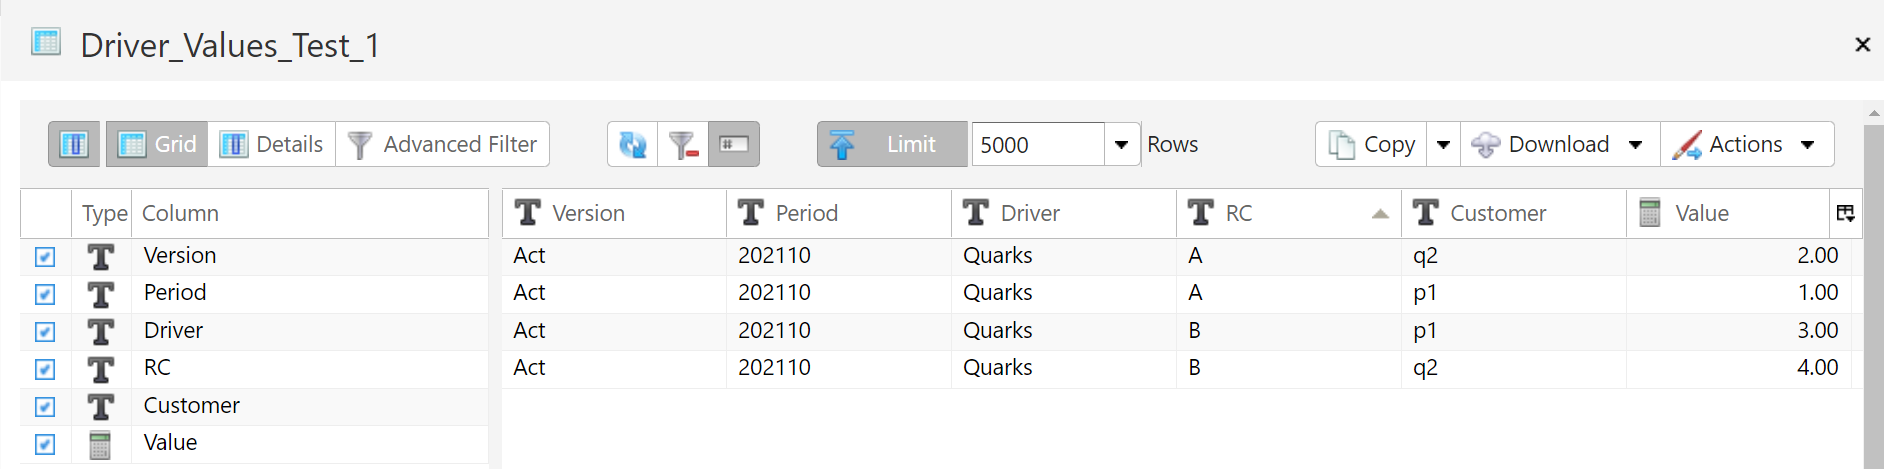
드라이버 데이터 테이블
할당 차원 계층
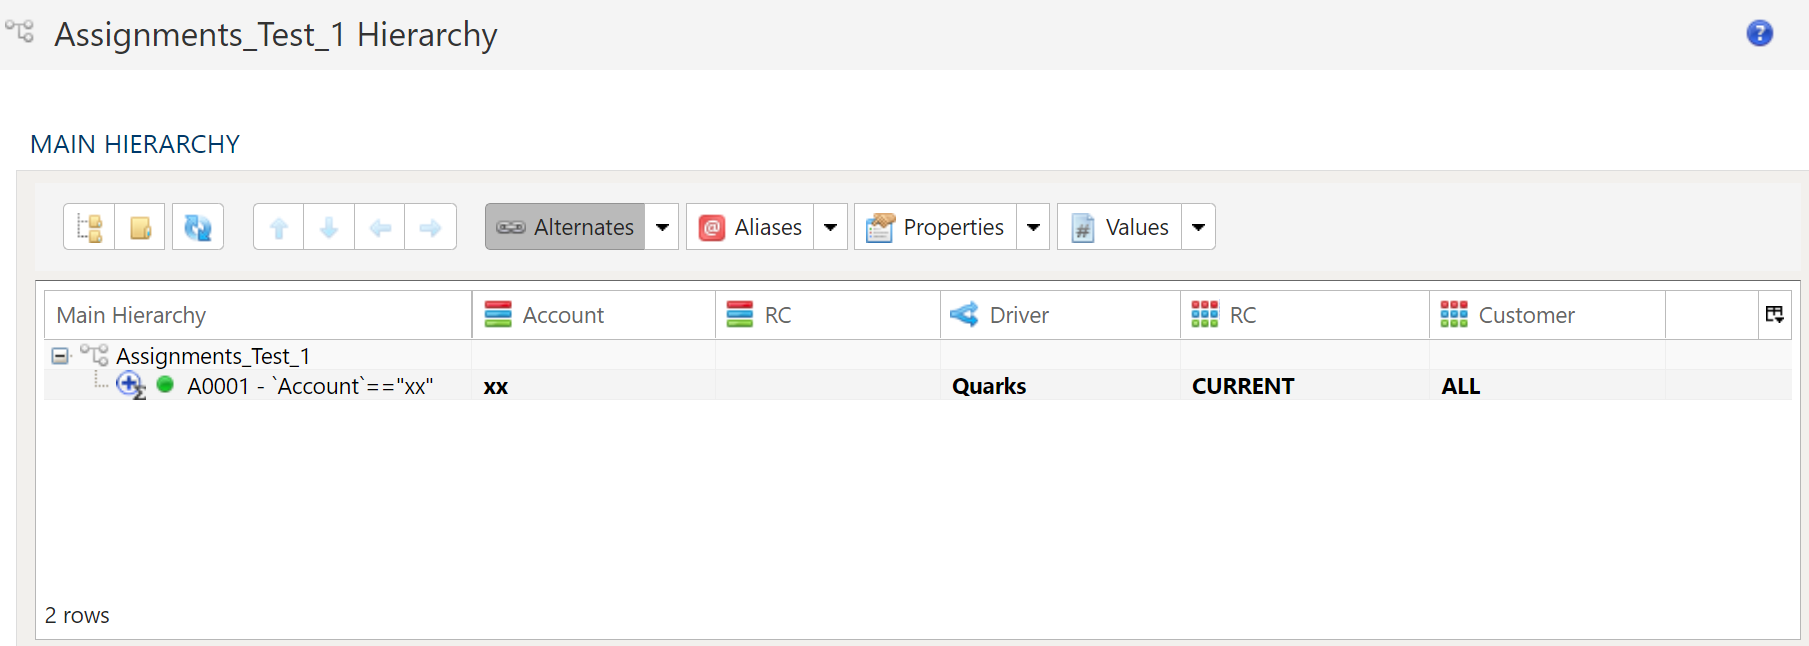
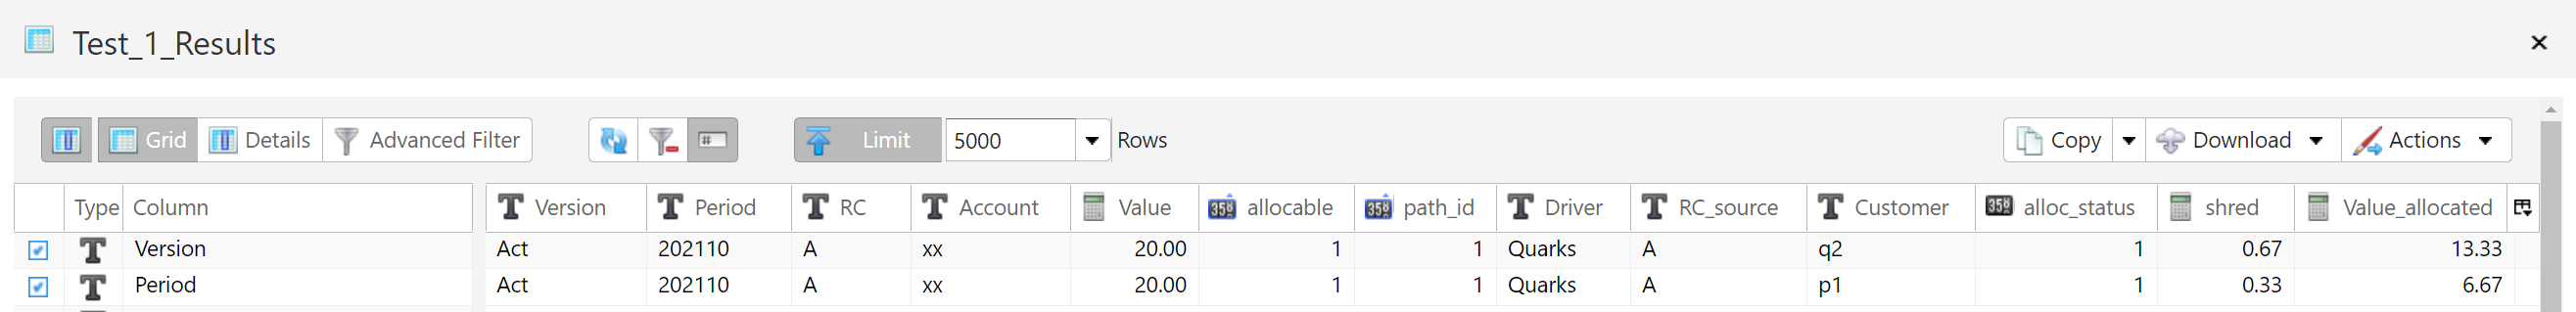
Target RC 차원이 현재로 설정되어 있으므로 드라이버 데이터는 배부할 값 테이블의 Source RC 값으로 필터링됩니다. Source RC에 있는 값이 “A” 하나뿐이므로, 배부 단계에는 RC = A인 드라이버 값 레코드만 사용됩니다.
배부 결과 테이블
예제 2
섹션 제목: “예제 2”배부할 값 테이블
드라이버 데이터 테이블
할당 차원 계층
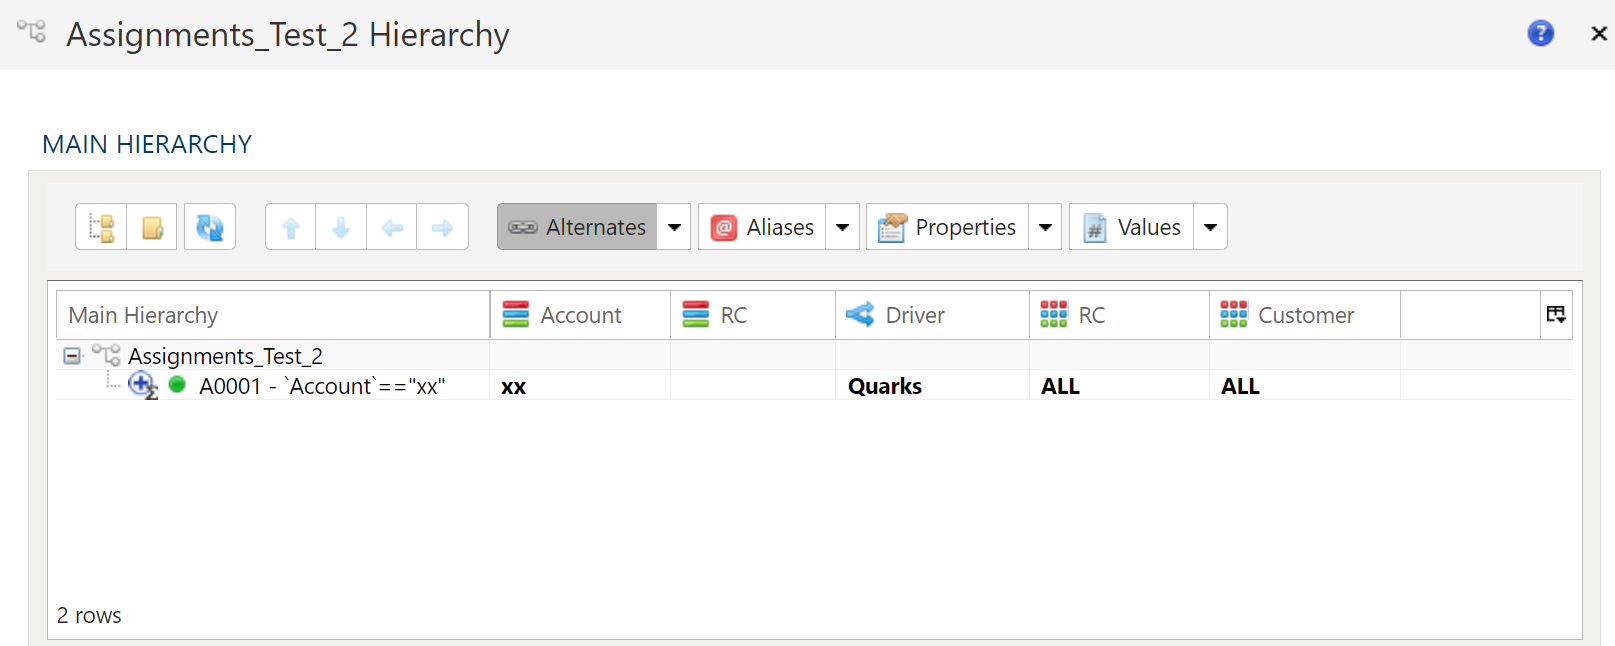
Target RC 차원이 ALL로 설정되어 있으므로 배부 결과 테이블의 RC 열에서 볼 수 있듯이 드라이버 데이터에는 모든 RC 값이 포함됩니다.
배부 결과 테이블
예제 3
섹션 제목: “예제 3”배부할 값 테이블
드라이버 데이터 테이블
할당 차원 계층
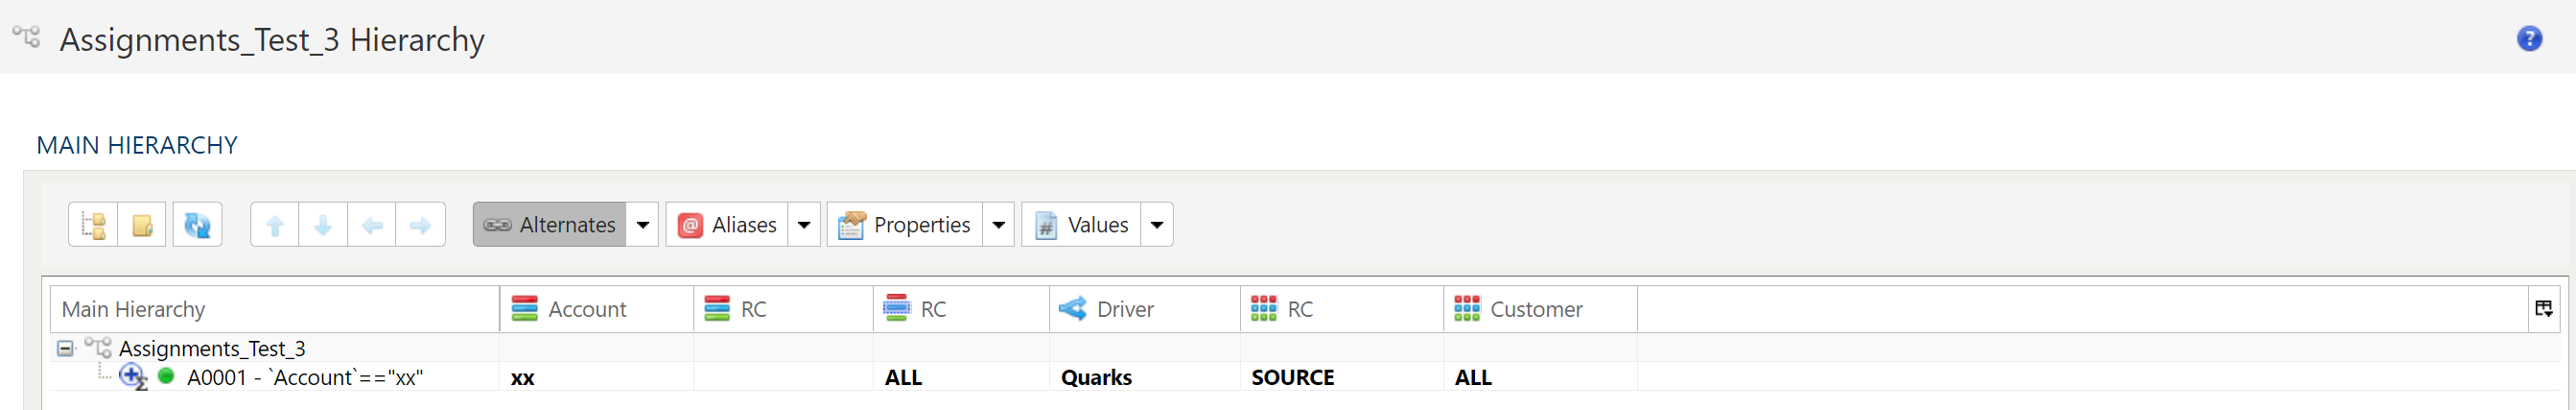
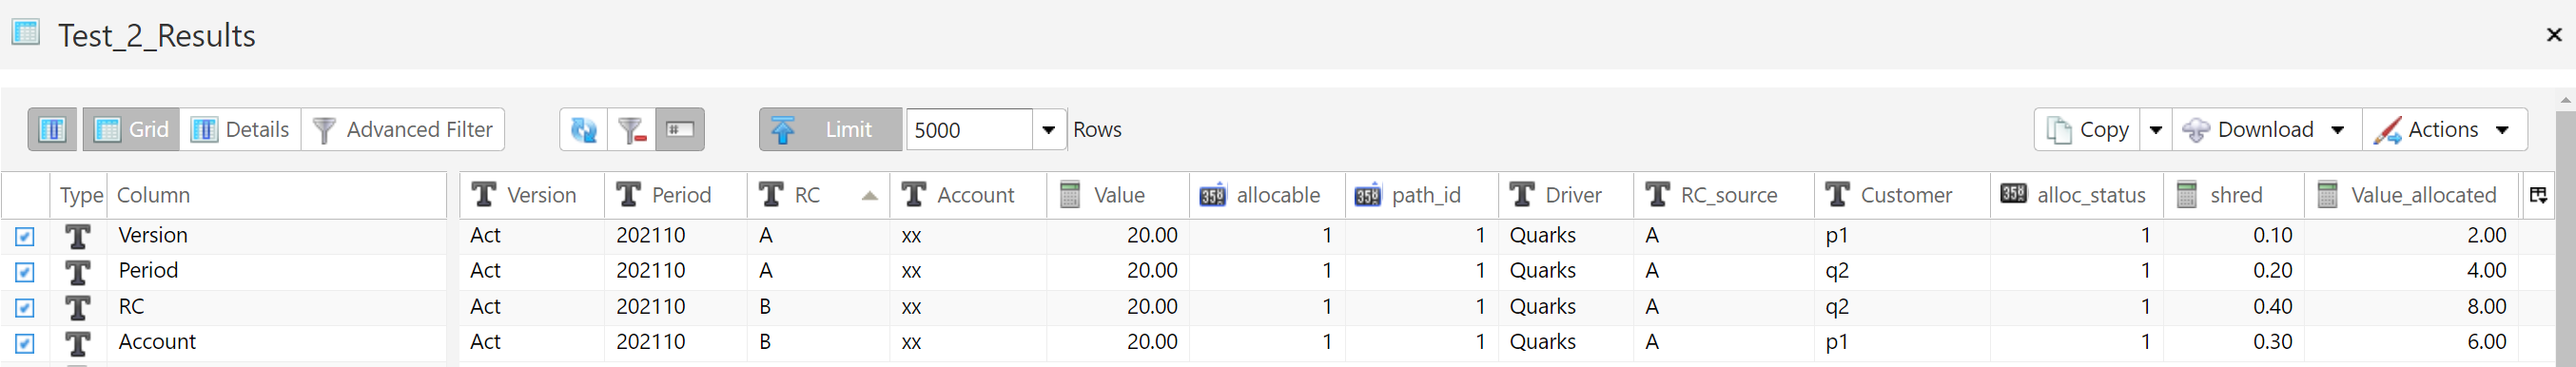
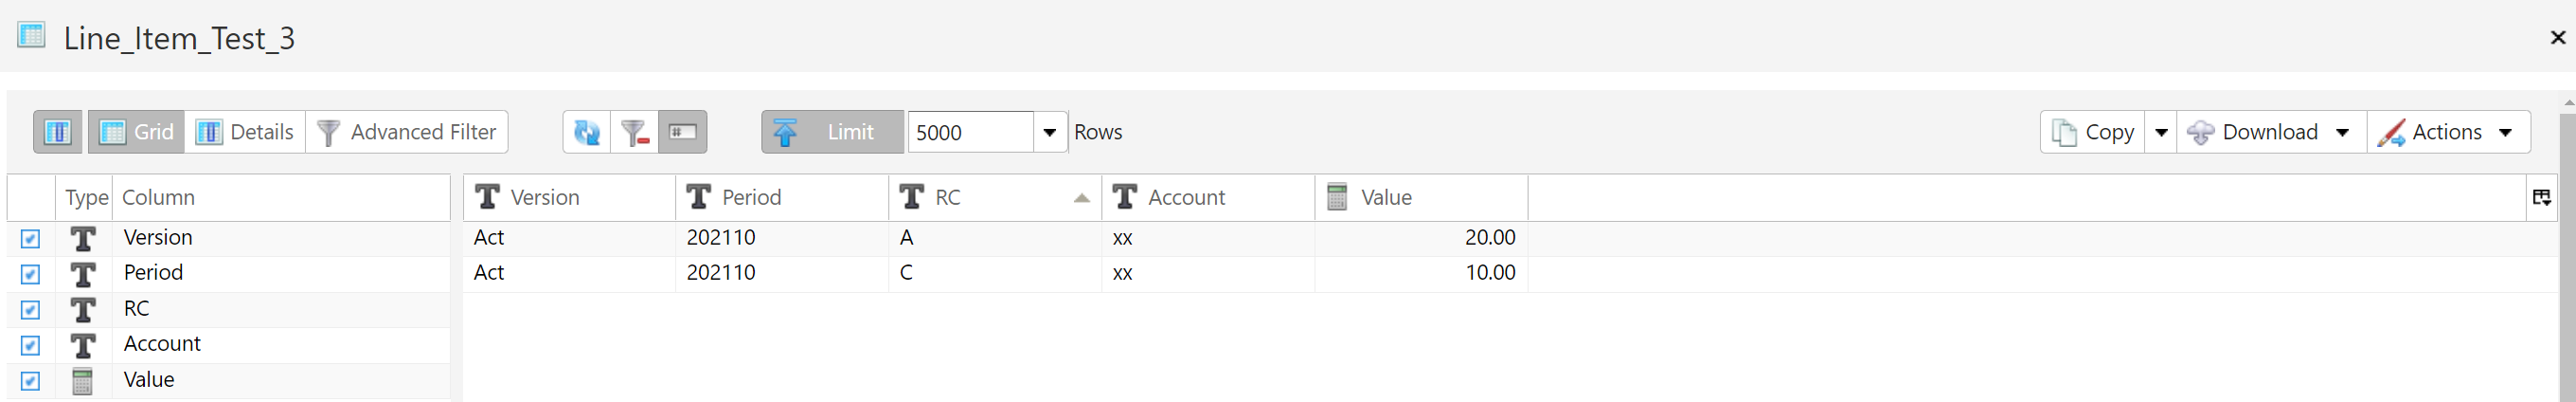
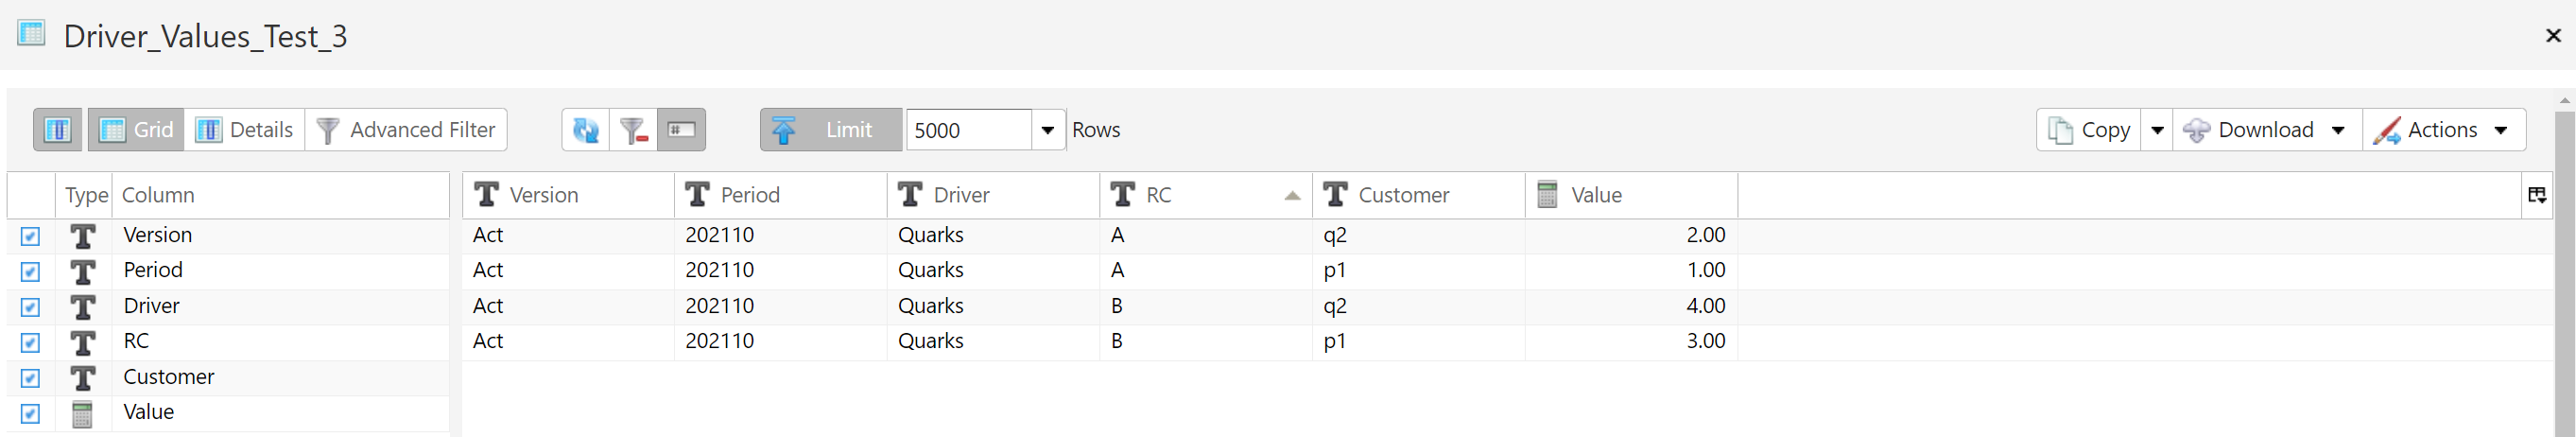
Context RC가 ALL로 설정되고 Target RC가 소스로 설정되어 있으므로 드라이버 데이터에는 드라이버 데이터의 모든 RC가 포함됩니다. Contect RC가 Target RC의 설정을 재정의합니다.
배부 결과 테이블
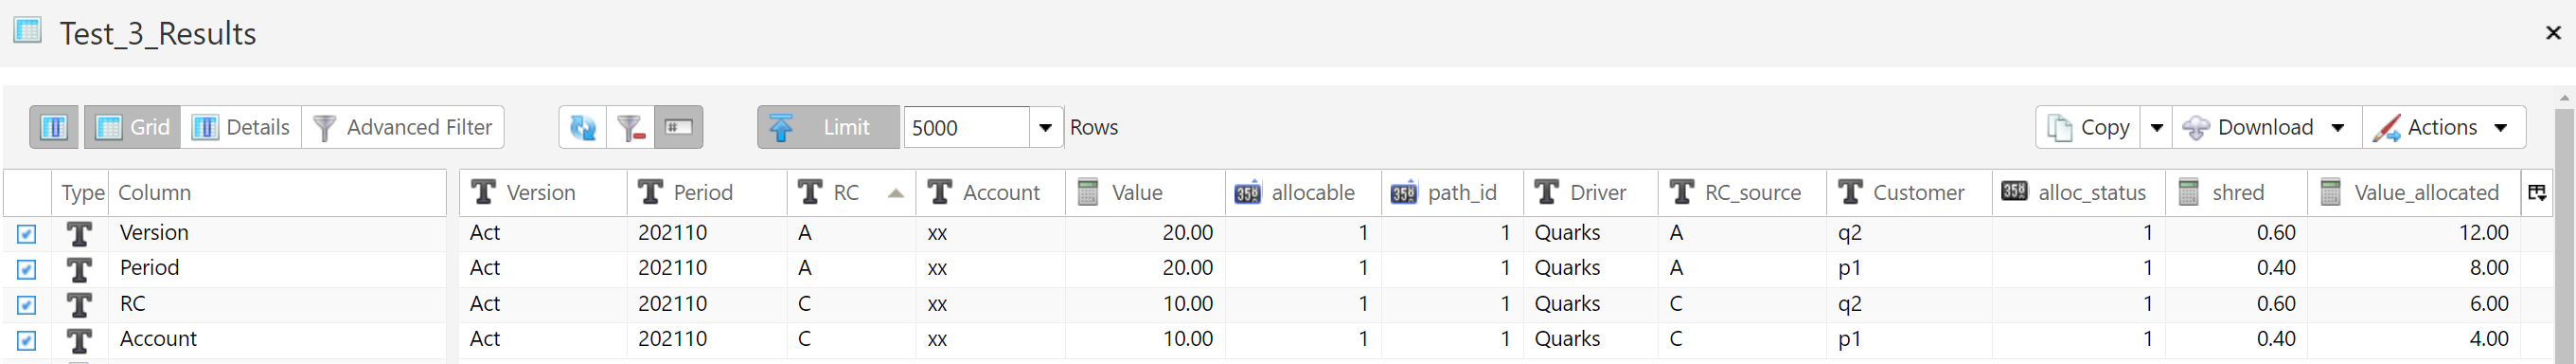
예제 4
섹션 제목: “예제 4”배부할 값 테이블
드라이버 데이터 테이블
할당 차원 계층
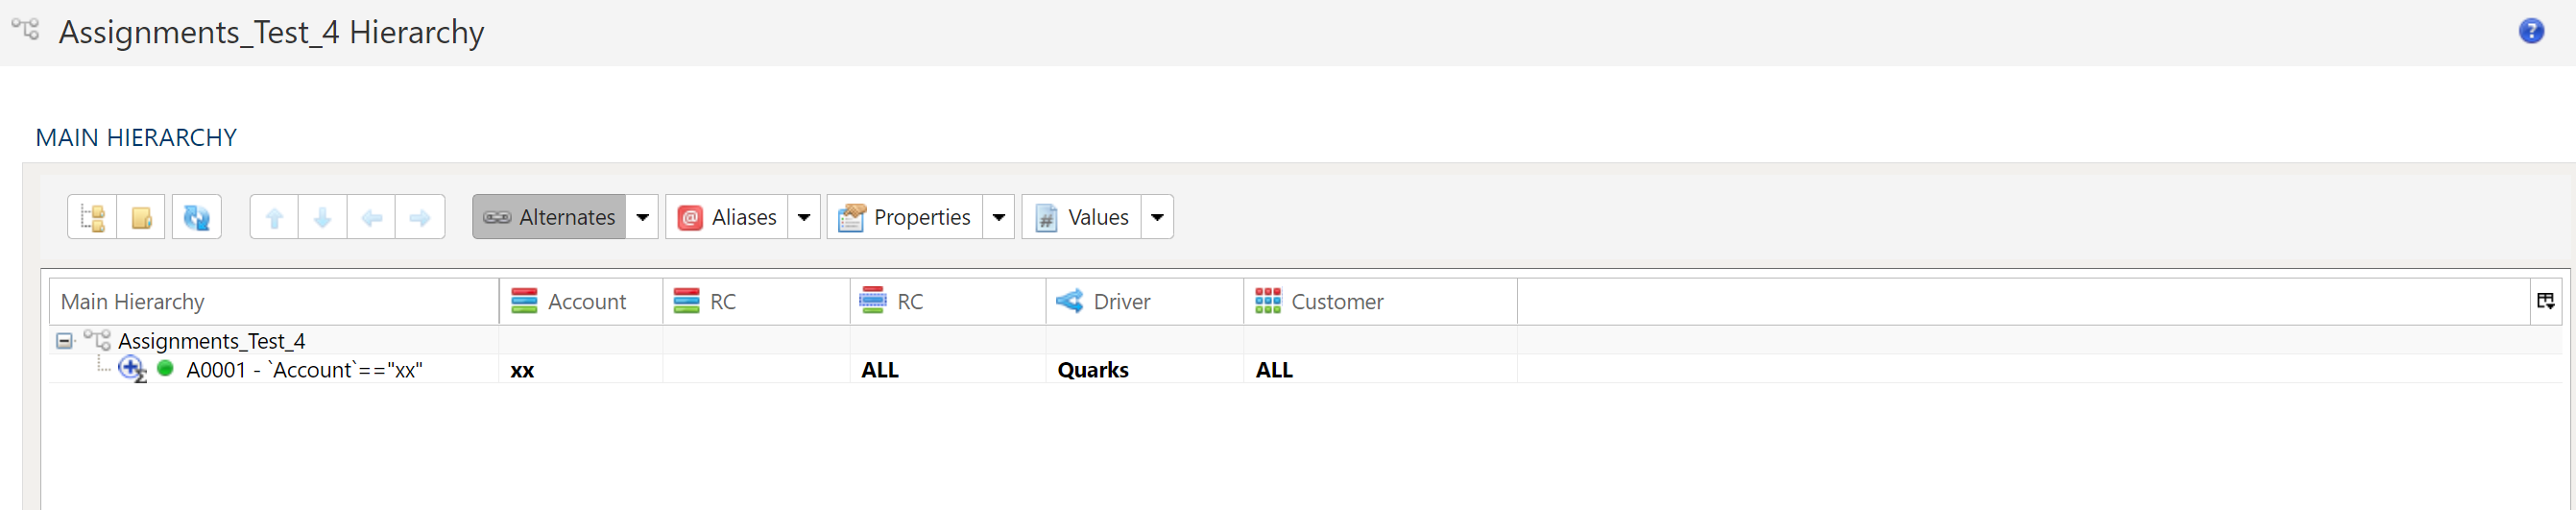
Context RC가 ALL로 설정되어 있으므로 드라이버 데이터에는 드라이버 데이터의 모든 RC가 포함됩니다.
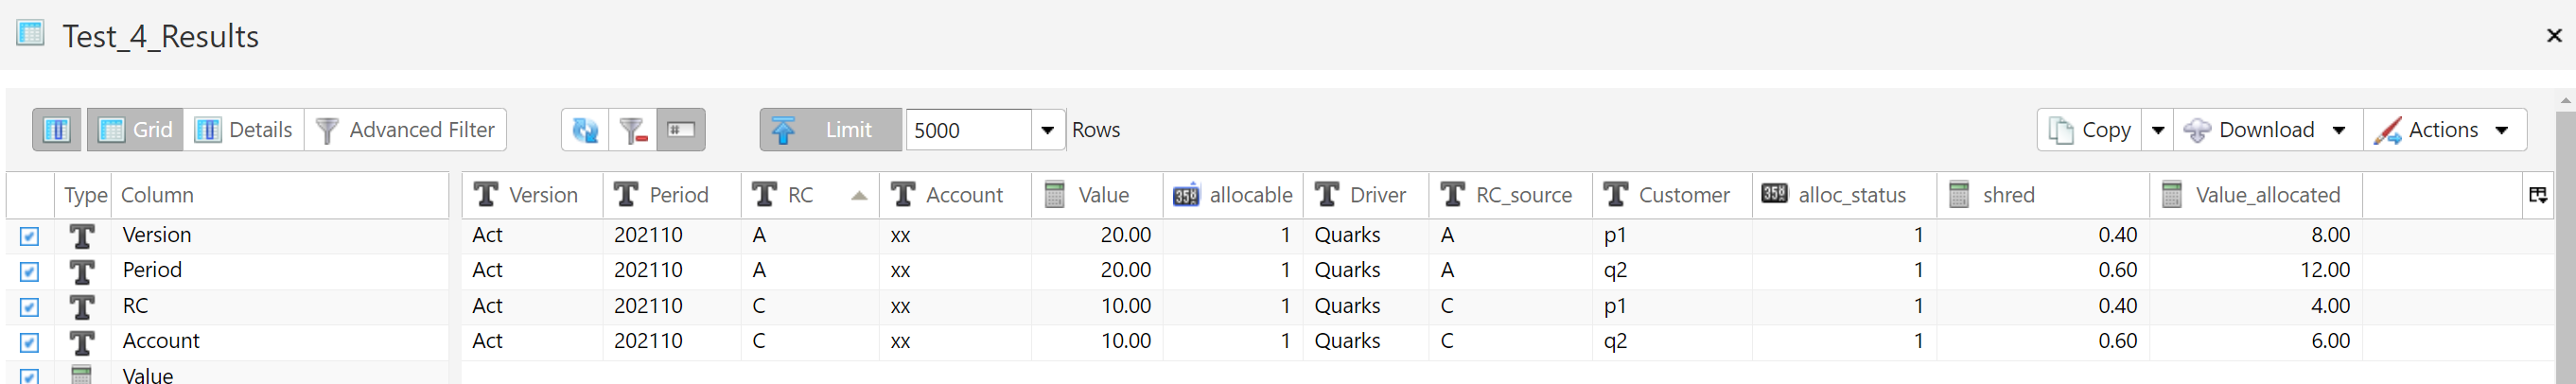
배부 결과 테이블